防止数据重复提交最简单的方案是什么
网站编辑2020-07-17 11:12:10647
防止数据重复提交最简单的方案是什么?这句话中包含了两个关键信息,第一:防止重复提交;第二:最简单。
到底是单机环境还是分布式环境?
得到的反馈是单机环境,那就简单了,于是我们就开始装*了。
话不多说,我们先来复现这个问题。
模拟用户场景
根据朋友的反馈,大致的场景是这样的,如下图所示:
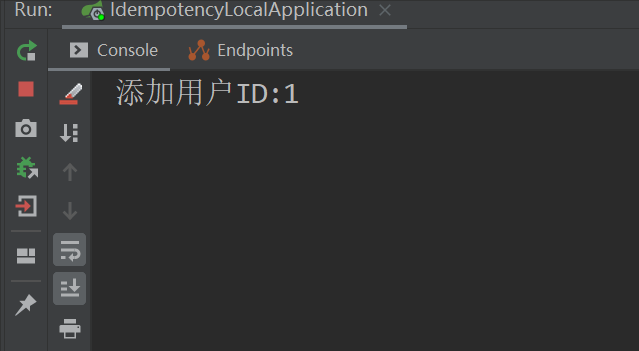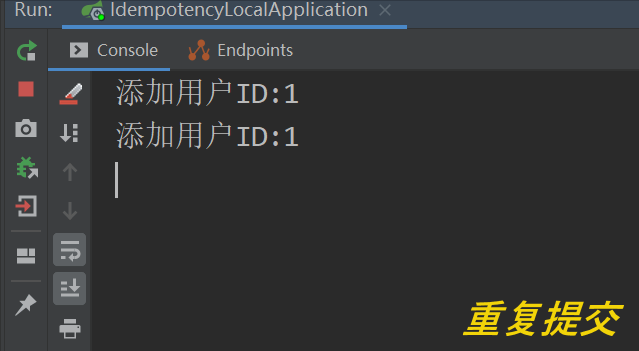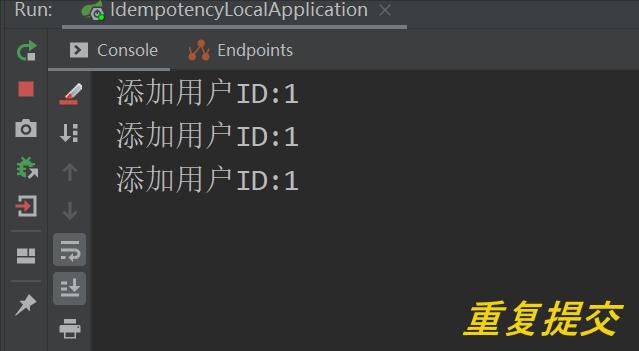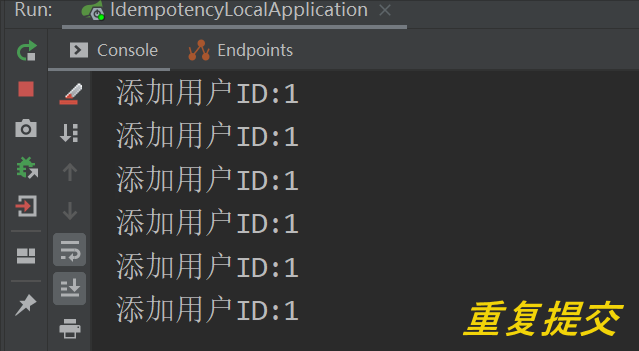
简化的模拟代码如下(基于SpringBoot):
| import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RestController;("/user")public class UserController { /** * 被重复请求的方法 */ ("/add") public String addUser(String id) { // 业务代码... System.out.println("添加用户ID:" + id); return "执行成功!"; }} |
前端拦截
前端拦截是指通过HTML页面来拦截重复请求,比如在用户点击完“提交”按钮后,我们可以把按钮设置为不可用或者隐藏状态。
执行效果如下图所示:
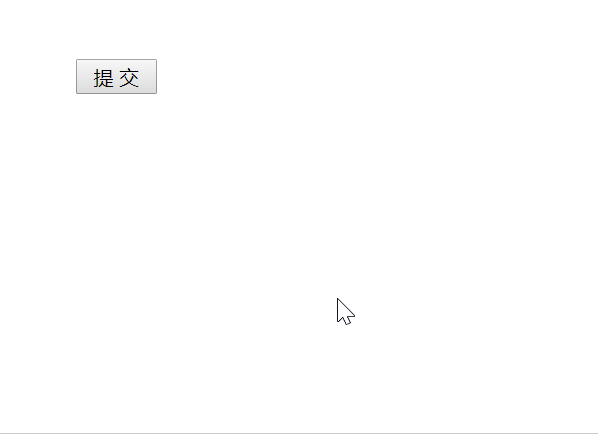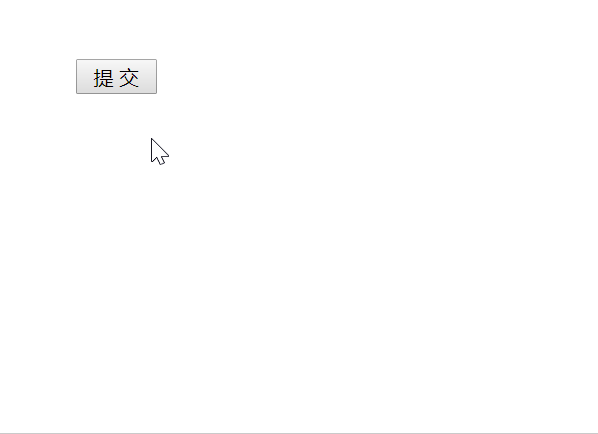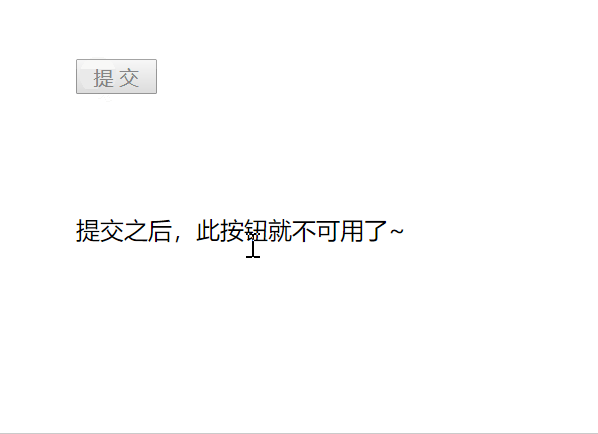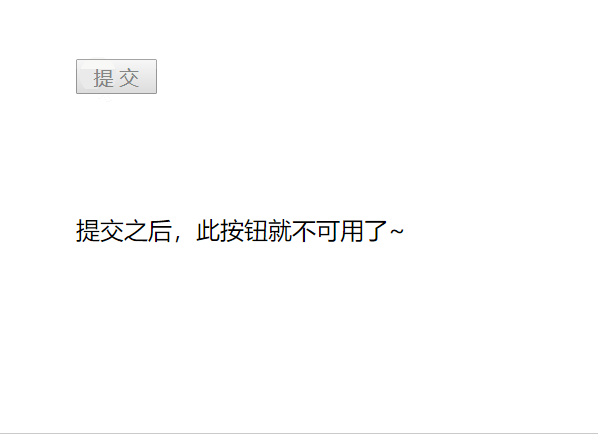
前端拦截的实现代码:
| <html><script> function subCli(){ // 按钮设置为不可用 document.getElementById("btn_sub").disabled="disabled"; document.getElementById("dv1").innerText = "按钮被点击了~"; }</script><body style="margin-top: 100px;margin-left: 100px;"> <input id="btn_sub" type="button" value=" 提 交 " onclick="subCli()"> <div id="dv1" style="margin-top: 80px;"></div></body></html> |
所以除了前端拦截一部分正常的误操作之外,后端的拦截也是必不可少。
后端拦截
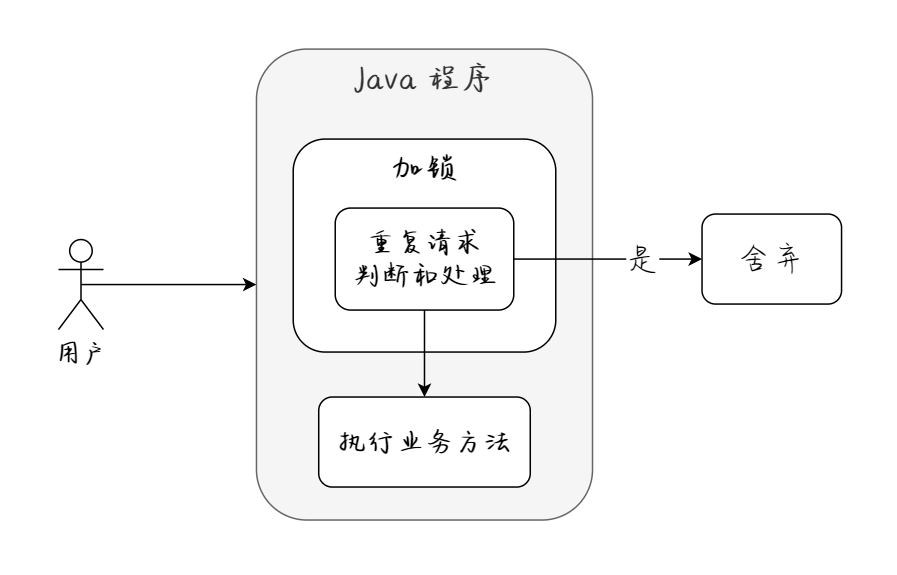
后端拦截的实现思路是在方法执行之前,先判断此业务是否已经执行过,如果执行过则不再执行,否则就正常执行。
我们将请求的业务ID存储在内存中,并且通过添加互斥锁来保证多线程下的程序执行安全,大体实现思路如下图所示:
然而,将数据存储在内存中,最简单的方法就是使用HashMap存储,或者是使用GuavaCache也是同样的效果,但很显然HashMap可以更快的实现功能,所以我们先来实现一个HashMap的防重(防止重复)版本。
1.基础版——HashMap
| import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RestController;import java.util.HashMap;import java.util.Map;/** * 普通 Map 版本 */("/user")public class UserController3 { // 缓存 ID 集合 private Map |
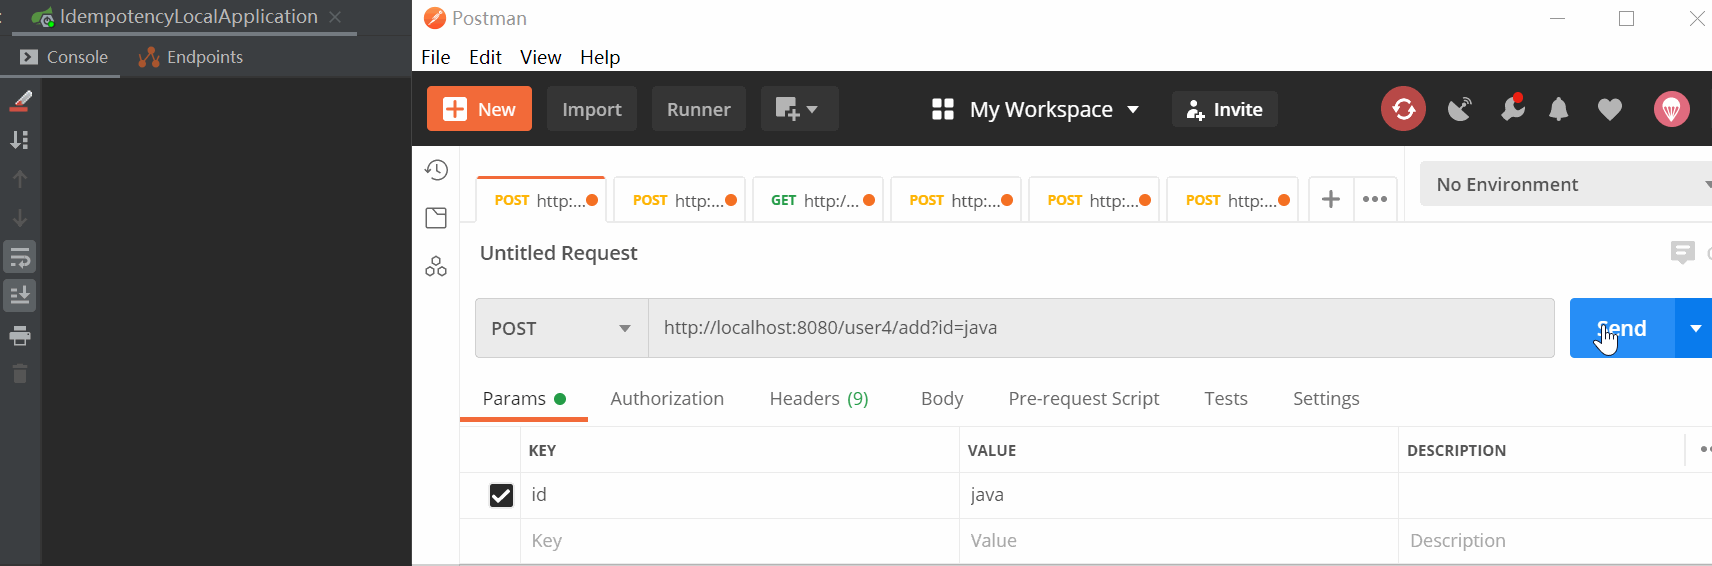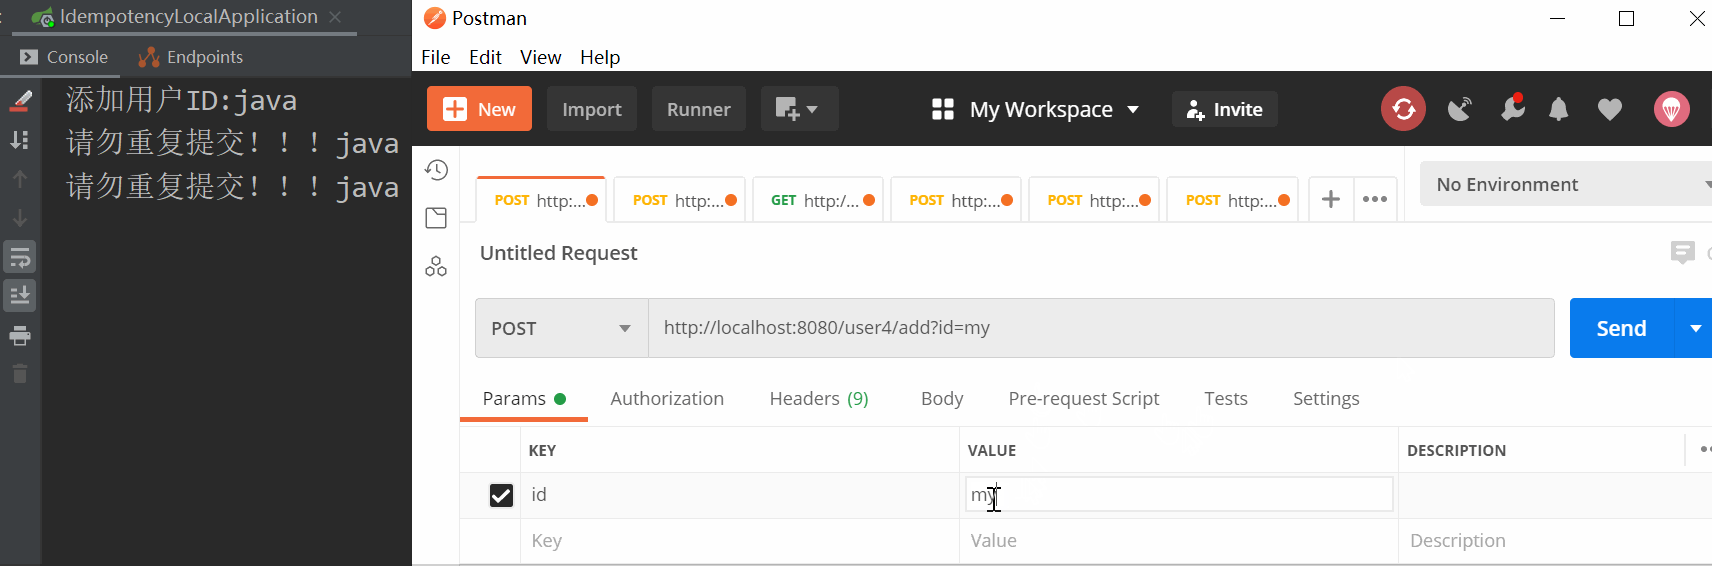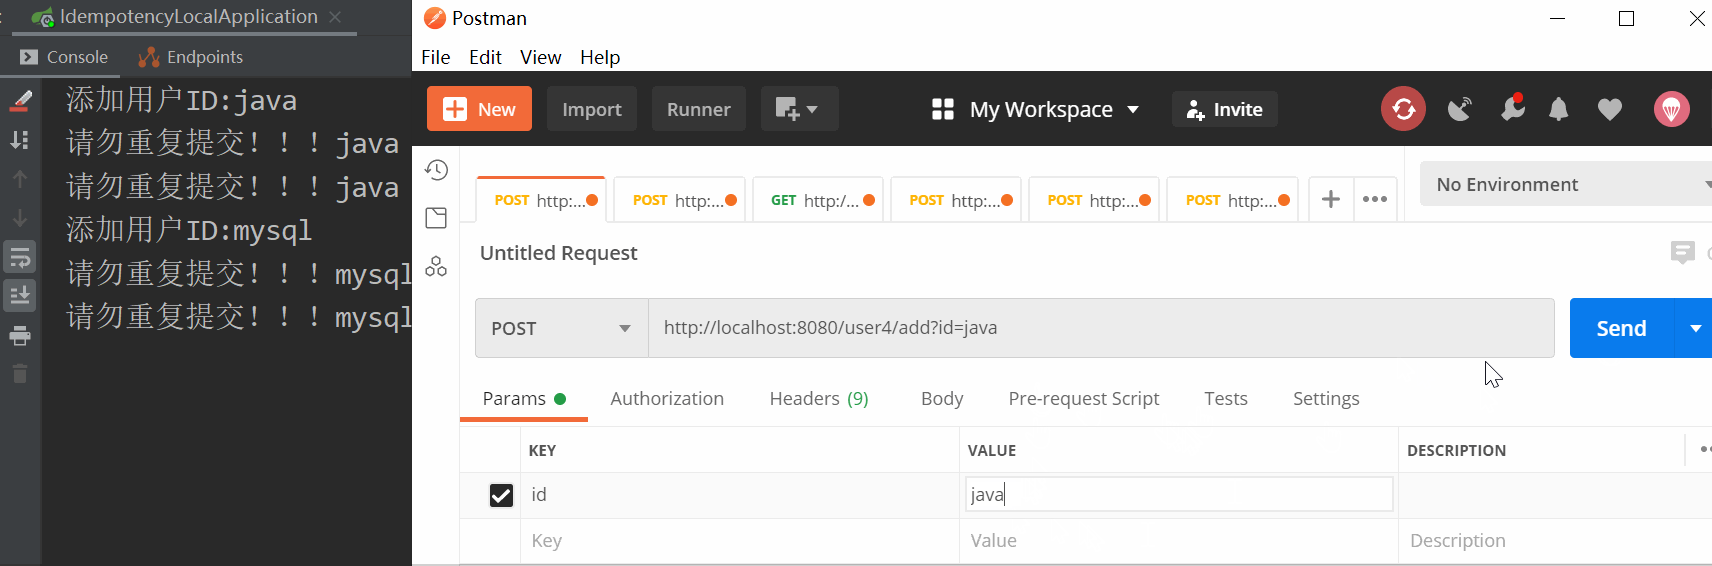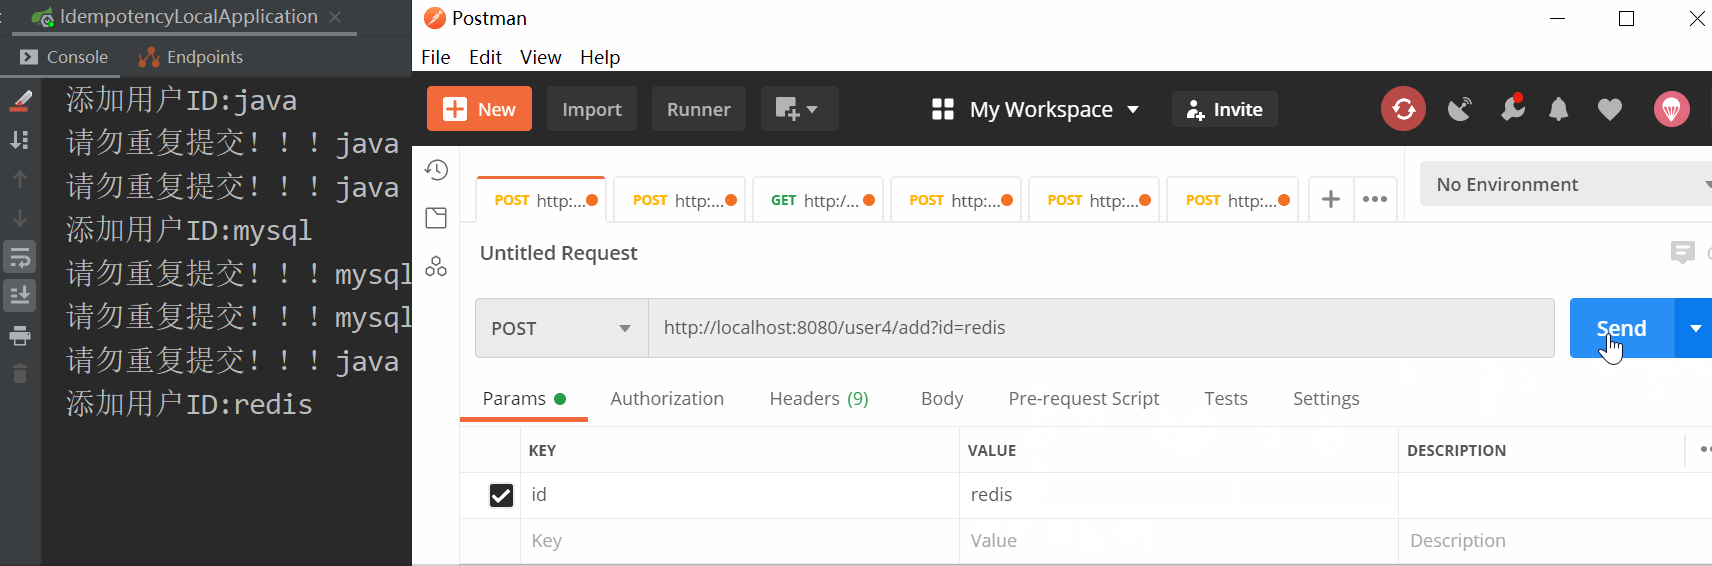
存在的问题:此实现方式有一个致命的问题,因为HashMap是无限增长的,因此它会占用越来越多的内存,并且随着HashMap数量的增加查找的速度也会降低,所以我们需要实现一个可以自动“清除”过期数据的实现方案。
2.优化版——固定大小的数组
此版本解决了HashMap无限增长的问题,它使用数组加下标计数器(reqCacheCounter)的方式,实现了固定数组的循环存储。
当数组存储到最后一位时,将数组的存储下标设置0,再从头开始存储数据,实现代码如下:
| import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RestController;import java.util.Arrays;("/user")public class UserController { private static String[] reqCache = new String[100]; // 请求 ID 存储集合 private static Integer reqCacheCounter = 0; // 请求计数器(指示 ID 存储的位置) ("/add") public String addUser(String id) { // 非空判断(忽略)... synchronized (this.getClass()) { // 重复请求判断 if (Arrays.asList(reqCache).contains(id)) { // 重复请求 System.out.println("请勿重复提交!!!" + id); return "执行失败"; } // 记录请求 ID if (reqCacheCounter >= reqCache.length) reqCacheCounter = 0; // 重置计数器 reqCache[reqCacheCounter] = id; // 将 ID 保存到缓存 reqCacheCounter++; // 下标往后移一位 } // 业务代码... System.out.println("添加用户ID:" + id); return "执行成功!"; }} |
上一种实现方法将判断和添加业务,都放入synchronized中进行加锁操作,这样显然性能不是很高,于是我们可以使用单例中著名的DCL(DoubleCheckedLocking,双重检测锁)来优化代码的执行效率,实现代码如下:
| import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RestController;import java.util.Arrays;("/user")public class UserController { private static String[] reqCache = new String[100]; // 请求 ID 存储集合 private static Integer reqCacheCounter = 0; // 请求计数器(指示 ID 存储的位置) ("/add") public String addUser(String id) { // 非空判断(忽略)... // 重复请求判断 if (Arrays.asList(reqCache).contains(id)) { // 重复请求 System.out.println("请勿重复提交!!!" + id); return "执行失败"; } synchronized (this.getClass()) { // 双重检查锁(DCL,double checked locking)提高程序的执行效率 if (Arrays.asList(reqCache).contains(id)) { // 重复请求 System.out.println("请勿重复提交!!!" + id); return "执行失败"; } // 记录请求 ID if (reqCacheCounter >= reqCache.length) reqCacheCounter = 0; // 重置计数器 reqCache[reqCacheCounter] = id; // 将 ID 保存到缓存 reqCacheCounter++; // 下标往后移一位 } // 业务代码... System.out.println("添加用户ID:" + id); return "执行成功!"; }} |
4.完善版——LRUMap
上面的代码基本已经实现了重复数据的拦截,但显然不够简洁和优雅,比如下标计数器的声明和业务处理等,但值得庆幸的是Apache为我们提供了一个commons-collections的框架,里面有一个非常好用的数据结构LRUMap可以保存指定数量的固定的数据,并且它会按照LRU算法,帮你清除最不常用的数据。
小贴士:LRU是LeastRecentlyUsed的缩写,即最近最少使用,是一种常用的数据淘汰算法,选择最近最久未使用的数据予以淘汰。
首先,我们先来添加Apachecommonscollections的引用:
| <dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-collections4</artifactId> <version>4.4</version></dependency> |
实现代码如下:
| import org.apache.commons.collections4.map.LRUMap;import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RestController;("/user")public class UserController { // 最大容量 100 个,根据 LRU 算法淘汰数据的 Map 集合 private LRUMap |
5.最终版——封装
以上都是方法级别的实现方案,然而在实际的业务中,我们可能有很多的方法都需要防重,那么接下来我们就来封装一个公共的方法,以供所有类使用:
| import org.apache.commons.collections4.map.LRUMap;/** * 幂等性判断 */public class IdempotentUtils { // 根据 LRU(Least Recently Used,最近最少使用)算法淘汰数据的 Map 集合,最大容量 100 个 private static LRUMap |
| import com.example.idempote.util.IdempotentUtils;import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RestController;("/user")public class UserController4 { ("/add") public String addUser(String id) { // 非空判断(忽略)... // -------------- 幂等性调用(开始) -------------- if (!IdempotentUtils.judge(id, this.getClass())) { return "执行失败"; } // -------------- 幂等性调用(结束) -------------- // 业务代码... System.out.println("添加用户ID:" + id); return "执行成功!"; }} |
扩展知识——LRUMap实现原理分析
既然LRUMap如此强大,我们就来看看它是如何实现的。
LRUMap的本质是持有头结点的环回双链表结构,它的存储结构如下:
既然LRUMap如此强大,我们就来看看它是如何实现的。
LRUMap的本质是持有头结点的环回双链表结构,它的存储结构如下:
| AbstractLinkedMap.LinkEntry entry; |
当调用查询方法时,会将使用的元素放在双链表header的前一个位置,源码如下:
| public V get(Object key, boolean updateToMRU) { LinkEntry |
| protected void addMapping(int hashIndex, int hashCode, K key, V value) { // 判断容器是否已满 if (this.isFull()) { LinkEntry |
| public boolean isFull() { return size >= maxSize;} |
容量未满就直接添加数据:
| super.addMapping(hashIndex, hashCode, key, value); |
如果容量满了,就调用reuseMapping方法使用LRU算法对数据进行清除。
综合来说:LRUMap的本质是持有头结点的环回双链表结构,当使用元素时,就将该元素放在双链表header的前一个位置,在新增元素时,如果容量满了就会移除header的后一个元素。
总结
本文讲了防止数据重复提交的6种方法,首先是前端的拦截,通过隐藏和设置按钮的不可用来屏蔽正常操作下的重复提交。但为了避免非正常渠道的重复提交,我们又实现了5个版本的后端拦截:HashMap版、固定数组版、双重检测锁的数组版、LRUMap版和LRUMap的封装版。
特殊说明:本文所有的内容仅适用于单机环境下的重复数据拦截,如果是分布式环境需要配合数据库或Redis来实现。
综合来说:LRUMap的本质是持有头结点的环回双链表结构,当使用元素时,就将该元素放在双链表header的前一个位置,在新增元素时,如果容量满了就会移除header的后一个元素。
总结
本文讲了防止数据重复提交的6种方法,首先是前端的拦截,通过隐藏和设置按钮的不可用来屏蔽正常操作下的重复提交。但为了避免非正常渠道的重复提交,我们又实现了5个版本的后端拦截:HashMap版、固定数组版、双重检测锁的数组版、LRUMap版和LRUMap的封装版。
特殊说明:本文所有的内容仅适用于单机环境下的重复数据拦截,如果是分布式环境需要配合数据库或Redis来实现。