阿里云如何购买大模型机器使用的详细步骤
网站编辑2025-09-27 12:17:44132
在人工智能和大数据时代,高性能计算资源成为企业与开发者的核心需求。阿里云作为国内领先的云计算服务商,提供了一系列适用于大模型训练与推理的计算资源。本文将系统解析阿里云如何购买大模型机器使用的详细步骤,帮助用户高效完成从选型到部署的全流程。
登录账号并明确需求
购买大模型机器的第一步是登录阿里云账号。若尚未注册,需先完成实名认证以确保账户安全性。登录后,进入“云服务器ECS”或“弹性高性能计算(E-HPC)”页面,明确自身需求:是用于训练超大规模模型(如千亿参数模型)还是进行推理部署?训练场景通常需要高内存、多GPU实例(如g8a或c8a系列),而推理场景可选择轻量级实例以降低成本。
关键决策点:
1. 地域与可用区:选择离业务用户最近的地域(如华北2北京),可降低网络延迟。
2. 网络类型:推荐使用专有网络(VPC)以增强安全性,尤其涉及敏感数据时。
3. 实例规格:根据模型规模选择GPU或TPU实例,例如训练大模型建议选择8卡V100或A100的实例。
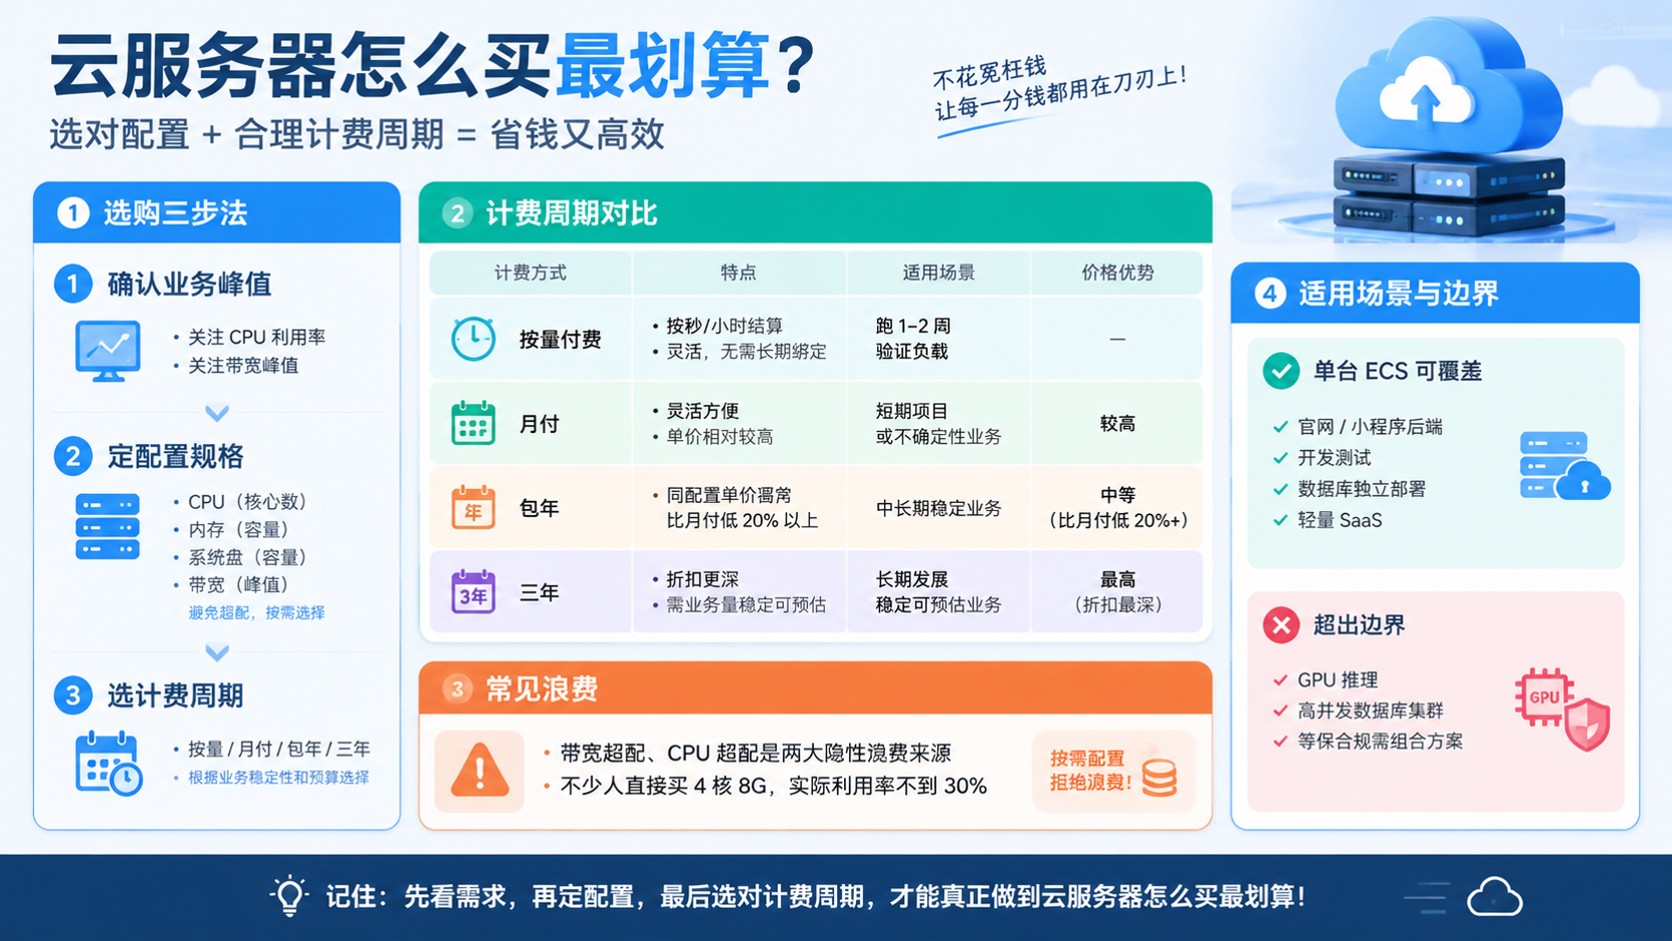
4. 购买时长:长期需求可选择包年包月(成本更低),短期测试可使用按量付费(灵活但费用较高)。
配置实例参数与网络环境
在实例创建页面,需细致配置以下参数:
- 版本与架构:大模型训练通常需要CUDA支持的NVIDIA GPU,选择匹配的Linux系统(如Ubuntu 20.04)及驱动版本。
- 存储配置:模型数据量庞大,建议搭配SSD云盘或ESSD云盘(吞吐量可达3000MB/s),并配置生命周期管理策略。
- 安全组设置:开放必要的端口(如22、80、443),若需远程调试可临时开放3389端口,但完成后应关闭以规避风险。
- 弹性公网IP:若需外网访问,需绑定EIP并配置带宽,但建议通过内网通信以提升效率。
案例说明:某AI实验室需训练图像识别模型,选择华北2地域的g8a.4xlarge实例(4*V100),搭配200GB ESSD云盘,并设置安全组仅允许实验室IP访问。
完成支付与后续管理
确认配置后,单击“立即购买”进入订单页。此时可使用代金券抵扣部分费用(如新用户优惠券),并选择资源组以便后续管理。支付完成后,阿里云将自动部署实例,用户可通过SSH连接至机器,安装CUDA、PyTorch或TensorFlow框架。
优化建议:
- 监控与告警:通过阿里云监控服务(CloudMonitor)实时查看GPU利用率、内存占用等指标,设置阈值告警避免资源浪费。
- 备份与恢复:定期创建自定义镜像或快照,确保模型数据安全。
- 成本控制:若训练周期较长,可结合“抢占式实例”降低50%以上费用,但需注意实例可能因资源不足被释放。
总结
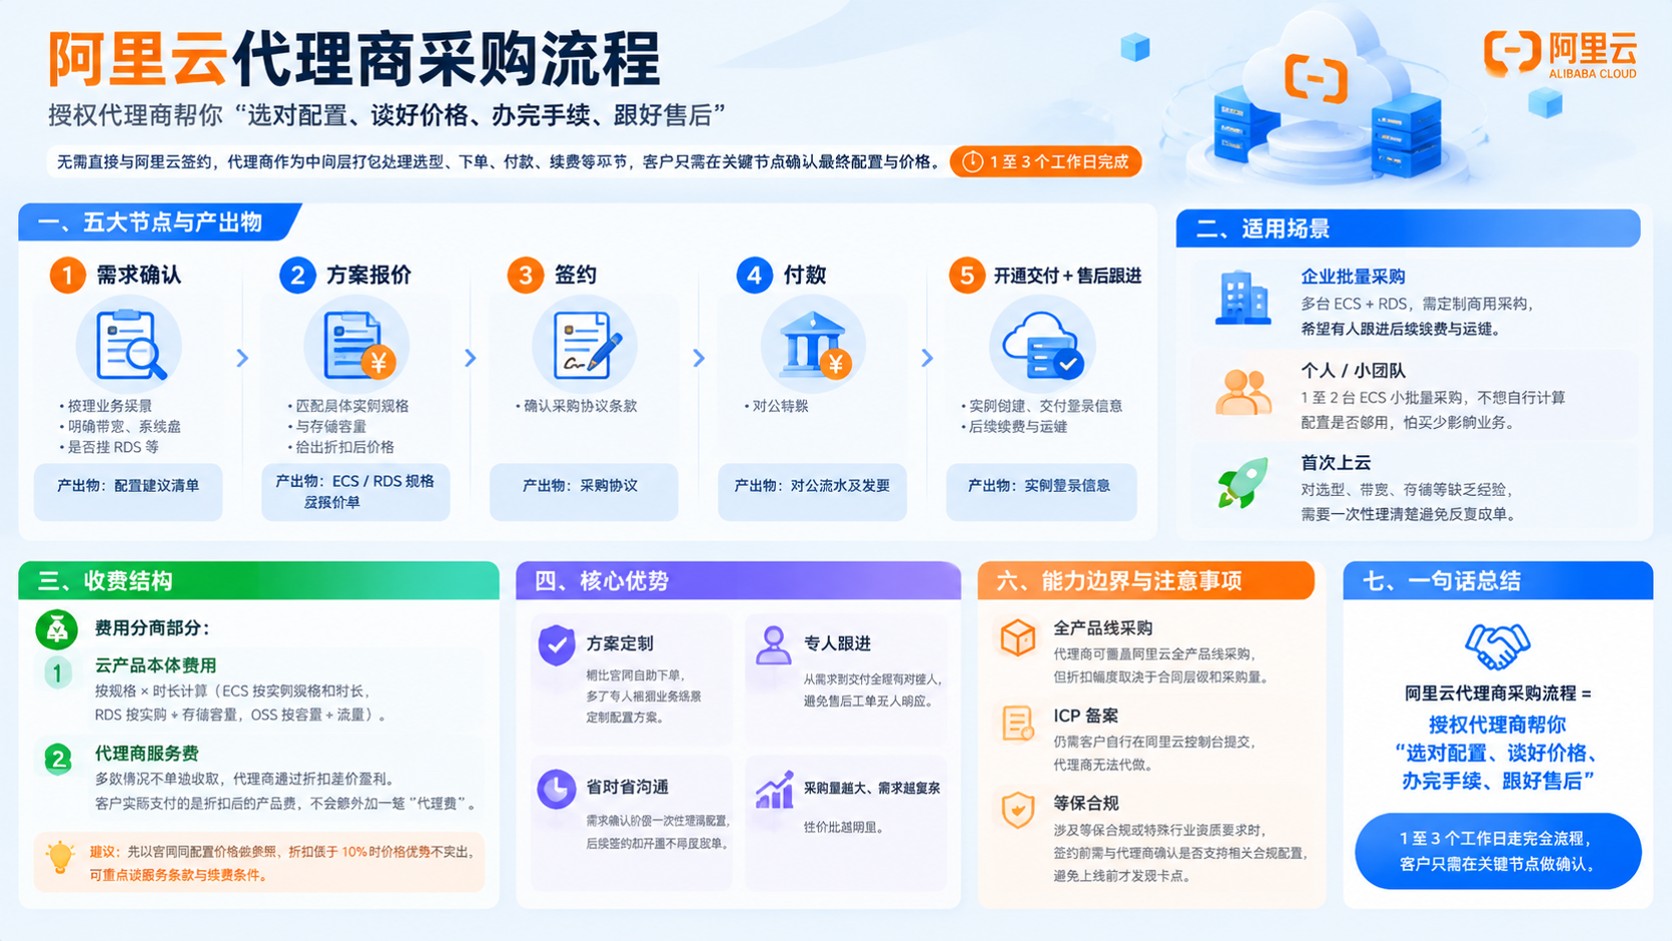
阿里云如何购买大模型机器使用的详细步骤涵盖需求分析、实例配置、支付部署及运维管理四大环节。通过合理选择地域、实例规格与存储方案,用户可构建高效稳定的AI训练环境。典名科技作为阿里云旗舰代理商,提供15%返现优惠及7*24小时技术支持,助力企业降本增效。无论是初创团队还是大型机构,遵循上述步骤并结合自身业务场景,都能快速上手阿里云大模型计算资源,加速AI创新落地。