更新时间: 2026-07-19

时序数据库是一种以事件为主线,按时间顺序组织数据的数据库。以下是一些时序数据库的主要数据结构,它们分别表示:事务:事务(Transaction)是一种特殊类型的数据存储,它保证数据的完整性和一致性。一个事务包括多个提交事务,它们按时间顺序处理数据,在每个事务中,事务管理器维护一个完整的事务序列,并且可以在事务结束后提交事务回滚。索引:索引是一种用于组织数据的元数据表类型,它定义了在数据存储
网站编辑2023-06-19 08:01:44214
简介时序数据库是一种专门用于存储和处理时间序列数据的数据库系统。它具有独特的数据结构,能够高效地存储和查询大量时间序列数据。本文将介绍时序数据库数据结构的特点,并通过一些示例来说明其优势。特点一:时间戳索引时序数据库中的数据通常以时间戳为索引进行存储。这意味着每个数据点都有一个唯一的标识符,即时间戳。这种索引方式使得查
网站编辑2024-02-22 08:29:16199
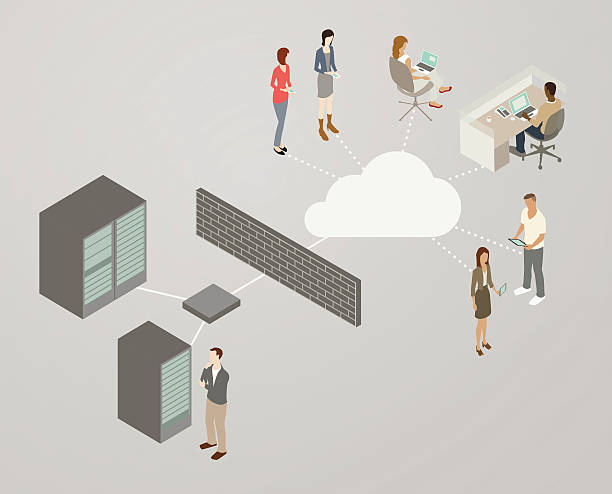
时序数据库的数据结构通常包括以下几个方面:1.时间戳:时序数据库最重要的特征就是时间序列数据,因此每个数据点都需要有一个时间戳来标识其时间。2.值:时序数据库存储的是时间序列数据,因此每个数据点都需要有一个对应的值来表示该时间点的数据。3.标签:标签是时序数据库中的一个重要概念,它可以用来对数据进行分类和过滤。标签通常包括键值对,例如设备名称、传感器类型等。4.数据库:时序数据库通常由多个数据库组
网站编辑2023-04-29 08:10:39391
简介:本文将详细介绍时序数据库中常用的数据结构及其类型,包括但不限于时间序列数据、离散事件数据、序列-序列数据等,并对其应用场景和优缺点进行详细的阐述。正文:时序数据库是一种专门用于存储和管理时间序列数据的数据库。这种数据库通常能够自动处理数据中的时间依赖关系,使得查询效率大大提高。时间序列数据时间序列数据是时序数据库
网站编辑2024-01-26 16:22:16184
简介时序数据库是一种专门用于存储和处理时间序列数据的数据库系统。它具有高效的数据存储和查询能力,适用于大规模的时间序列数据处理。在时序数据库中,数据结构的设计对于性能和效率至关重要。本文将介绍时序数据库常见的数据结构,并解释它们的特点和用途。数据结构1.时间戳(Timestamp)时间戳是时序数据库中最基本的数据结构之
网站编辑2024-01-31 14:29:39165

时序数据库是一种专门用于存储和处理时间序列数据的数据库,其数据结构与传统的关系型数据库有所不同。以下是时序数据库常用的数据结构:1.时间戳(Timestamp):时序数据库中最基本的数据结构,用于记录数据的时间戳信息。时间戳通常是一个整数或浮点数,表示数据采集的时间点或时间段。2.标签(Tag):标签是时序数据库中用于描述数据的元数据,通常包括设备名称、传感器类型、地理位置等信息。标签可以帮助用户
网站编辑2023-05-22 12:24:28254

时序数据库是一种专门用于存储和处理时间序列数据的数据库。它的数据结构通常是基于列式存储的,以便更好地支持时间序列数据的查询和分析。时序数据库的数据结构通常由以下几个部分组成:1.时间戳:每个数据点都有一个时间戳,用于标识数据点的时间。2.数据值:每个数据点都有一个数据值,用于表示该时间点的数据。3.标签:标签是用于描述数据点的元数据,例如传感器的位置、设备的型号等等。4.数据库索引:时序数据库通常
网站编辑2023-05-18 10:56:58665
简介:本文将详细介绍时序数据库中常用的数据结构类型,包括时间序列、事件序列和关系型数据库。这些类型在处理大规模的时序数据时具有重要的应用价值。正文:一、时间序列时间序列数据是时序数据库中最基础的数据类型,其主要特点是以时间作为唯一索引。例如,温度数据、股票价格数据等都是时间序列数据。时间序列数据通常采用时间戳表示时间,
网站编辑2024-01-25 17:47:15188
简介时序数据库是一种专门用于存储和处理时间序列数据的数据库系统。在时序数据库中,数据以时间戳为索引进行存储,可以高效地进行时间序列数据分析和查询。时序数据库的数据结构是其核心组成部分之一,不同的数据结构决定了时序数据库的性能和功能。数据结构类型1.时间序列数据结构时间序列数据结构是最基本的时序数据库数据结构,它将数据按
网站编辑2024-02-14 07:43:52419
简介时序数据库是一种专门用于存储和处理时间序列数据的数据库系统。在现代数据处理中,时间序列数据是非常重要的一种数据类型,它包含了随时间变化的数据,例如传感器数据、股票价格等。时序数据库的设计和实现通常涉及到一些特定的数据结构,以支持高效的数据存储和查询操作。数据结构的重要性在时序数据库中,数据结构的设计对于性能和效率起
网站编辑2024-01-12 17:53:03174

数据库表结构由以下几个部分组成:1.数据库表名:即数据库中的字段名称,可以是任意长度的字符串或数组名。2.数据类型:即数据存储的类型,如字符型、字符串型、数字型、日期型等。3.数据存储位置:即数据在哪个表中存在,是在表中的哪个字段中存储,如在字段为“name”的表中存储用户名,在字段为“age”的表中存储年龄等。4.数据库表关联关系:即数据存储之间的关系,如表中的“Name”关联到“age”
网站编辑2023-05-20 17:08:16354
简介数据库系统是现代计算机应用中不可或缺的一部分,它用于存储、管理和检索数据。数据库系统的结构由多个组成部分构成,这些组成部分共同协作,以实现高效的数据管理和访问。组成部分1.数据库管理系统(DBMS)数据库管理系统是数据库系统的核心组件,它负责管理数据库的创建、维护和操作。DBMS提供了一系列的功能和工具,使用户能够
网站编辑2024-02-07 07:35:59236

针对AI场景支持正排、全文、向量融合检索和AI推理能力;兼容MySQL协议、HBase、ES、Hive、Spark、HDFS等开源标准。提供宽表、时序、向量等数据模型,是互联网、车联网、广告、金融、监控、游戏等场景的首选
¥2436.00/月
1年85折
基于云原生架构,软硬协同优化,提供稳定可靠、高性价比的数据库服务。通过丰富的插件拓展,支撑各领域场景化业务,如自研Ganos多维多模时空引擎及开源PostGIS地理信息引擎、向量引擎、时序引擎等百余款插件。
¥1231.20/年
1年7.5折起 不限数量