
更新时间: 2026-07-07

如果您的阿里云账号与阿里云OS账号不在同一个局域网内,可能无法将语音数据保存到本地。请按照以下步骤尝试保存语音合成的保存位置:1.确认您在阿里云账号和阿里云OS账号上都有相同的账号信息,可以通过阿里账号登录阿里云OS账号管理中心,进入“设置-应用程序-开发人员工具-开发人员工具”,然后选择您的阿里云OS账号,在“开发人员工具”中找到“本地存储-导出”。2.在“本地存储-导出”中,选择“导出”按钮,
网站编辑2023-05-21 17:24:37302
阿里云人工智能语音合成服务是一个基于自然语言处理技术的语音合成服务,旨在向用户提供高效、便捷和个性化的合成服务。用户通过使用语音合成服务,可以将自己的声音变成任意文本,从而实现更加自然的语音交流。语音合成服务基于阿里云的人工智能技术,包括机器学习、深度学习等多个领域的技术,通过大量的语音数据训练,可以让用户的语音更加生动、自然和富有表现力。用户可以使用语音合成服务将自己的声音转换成文本,并通过选择
网站编辑2023-05-21 17:24:16219
阿里云智能语音合成可以通过在阿里云智能平台上使用语音识别技术来完成语音合成应用。以下是使用语音识别技术来完成语音合成的简单方法:1.登录阿里云智能平台并进入个人中心,点击“语音合成”按钮。2.在语音合成界面,找到“语音转换”选项。3.在下方菜单栏中,选择“语音合成”选项。4.选择要进行语音合成的文本,例如“请输入您希望合成的文本”。5.点击“语音转换”按钮,即可转换为语音文件,并开始进行语音合成。
网站编辑2023-05-21 17:23:46248
阿里云智能语音合成服务(AliGenie)可以通过API接口调用阿里云智能语音合成服务,以下是一些常用的方法:1.登录阿里云智能语音合成服务的网站:https://api.aliyun.com/2.搜索AliGenie服务,找到需要的服务,点击下载并安装:https://yun.aliyun.com/download/AliGenie-client3.打开AliGenie,在界面中选择“开始”菜单
网站编辑2023-05-19 11:37:46262
阿里云语音合成有什么优势?阿里云语音合成有多种音色可供选择,并提供调节语速、语调、音量等功能。那么,阿里云语音合成都具备哪些优势呢?接下来我们就来详细了解一下吧。
网站编辑2023-01-11 10:36:48234

简介在数字化浪潮中,语音技术正成为连接人与设备的关键桥梁。阿里云语音合成租赁服务,凭借高拟真度与灵活配置,为各行业提供高效、低成本的语音解决方案。本文将深入解析其核心优势、应用场景及租赁流程,帮助用户全面了解这一前沿技术。阿里云语音合成租赁的核心优势阿里云语音合成租赁并非简单的“按需付费”,而是通过云端资源弹性分配,实
网站编辑2025-07-20 09:18:5955
阿里云提供调节语速、语调、音量等功能,可以转换成自然流畅的语音,并积累了大量的词库在智能家居、车载、导航、金融、银行、保险、证券、运营商、物流、房地产、教育等众多领域,让阿里云语音合成在各领域、各行业的词汇发音更准确。那么,阿里云文字转语音价格多少钱呢?阿里云语音合成多种音色可供选择,并提供调节语速、语调、音量等功能。可以自助开通后付费或购买预付费资源包。以下是阿里云语音合成资源包的费用:语音合成
网站编辑2023-06-19 09:55:48179
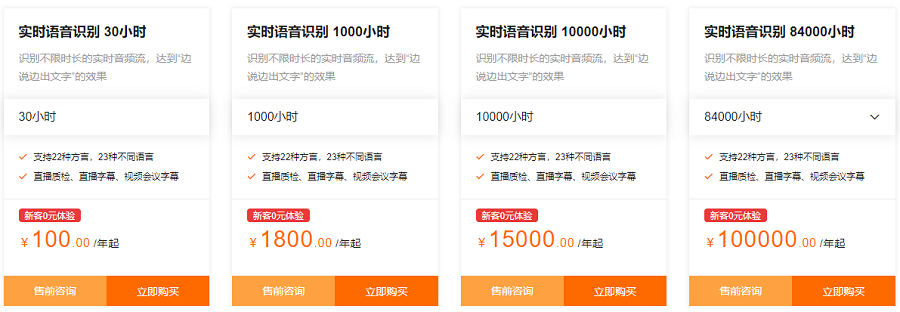
阿里云文字转语音价格多少钱?实时语音识别是对不限时长的音频流做实时识别,达到“边说边出文字”的效果,内置智能断句,可提供每句话开始结束时间。可用于视频实时直播字幕、实时会议记录、实时法庭庭审记录、智能语音助手等场景。
网站编辑2023-05-17 10:04:451457
随着人工智能技术的不断发展,语音识别已经成为了人们生活中不可或缺的一部分。阿里云作为国内领先的云计算服务提供商之一,提供了一系列优质的语音识别服务。本文将为您详细介绍如何设置阿里云语音识别政策,以及如何充分利用其最好的功能。在使用阿里云语音识别服务之前,首先需要设置一些基本的政策,以便更好地保护用户的信息安全和隐私。这
网站编辑2024-12-15 10:46:3782

阿里云语音识别是阿里巴巴集团推出的一项语音技术,可以让用户将音频文件转换为文本。语音识别返点功能可以帮助用户通过使用阿里云语音识别获得现金返利。这篇文章将介绍阿里云语音识别返点功能的设置方法,让用户更好地利用这项功能。阿里云语音识别返点功能是指用户在使用阿里云语音识别服务时,可以赚取现金返利。用户可以通过语音转文字的方
网站编辑2024-11-23 13:52:08192

在数字化浪潮席卷全球的今天,语音技术正以前所未有的速度重塑人机交互方式。阿里云语音合成活动作为行业标杆,凭借其高拟真度、灵活配置和深度定制能力,正在为各行业注入智能化新活力。从智能客服到虚拟主播,从车载导航到教育场景,这项技术正以“声音的魔法”打破传统交互壁垒,让冰冷的机器焕发人性温度。技术革新:阿里云语音合成活动的核
网站编辑2025-06-10 07:33:4855
阿里云语音合成如何收费的?这是许多企业在部署智能客服或语音交互系统时最先关注的财务细节。根据公开文档,其计费通常采用预付费资源包模式,例如基础版约 30 万次调用起售,价格在一百元级别;而百万次以上的大规模调用则通过阶梯定价降低单次成本。这种“用量越大单价越低”的逻辑在云行业具有普遍性。然而,单纯盯着标价往往会导致预算失控,因为实际成本还取决于并发量、音色类型及长文本处理需求。理解计费模型背后的业
网站编辑2026-05-12 21:07:2917

