千问Qwen3.7-Flash价格:最新计费明细
网站编辑2026-10-01 14:54:0287
千问大模型Qwen3.7-Flash价格是多少,输入单价低至0.02元/百万Tokens,按调用量阶梯计费,当前还有100万Tokens免费额度(到期前用完等于零成本)。典名科技是阿里云代理商,可协助确认最新阶梯档位并对接百炼平台开通。适合需要接入多模态大模型API但缺专职AI工程团队的开发者和中小团队,看完本文可直接对照明细做预算。
千问大模型Qwen3.7-Flash价格是多少:输入输出与工具调用
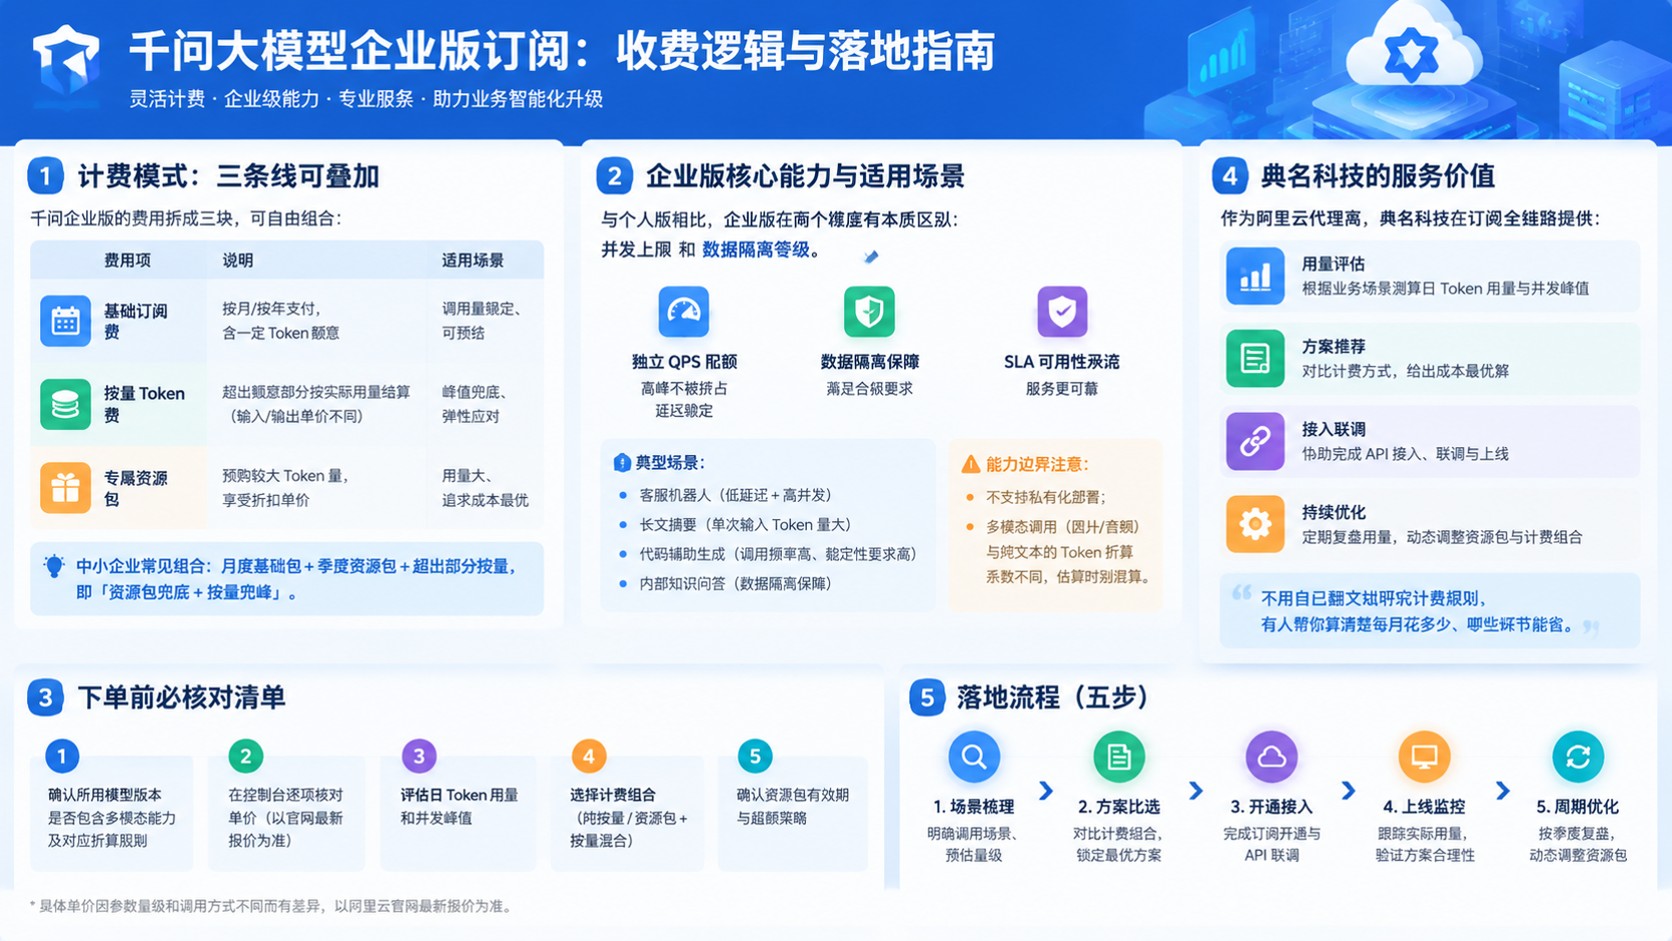
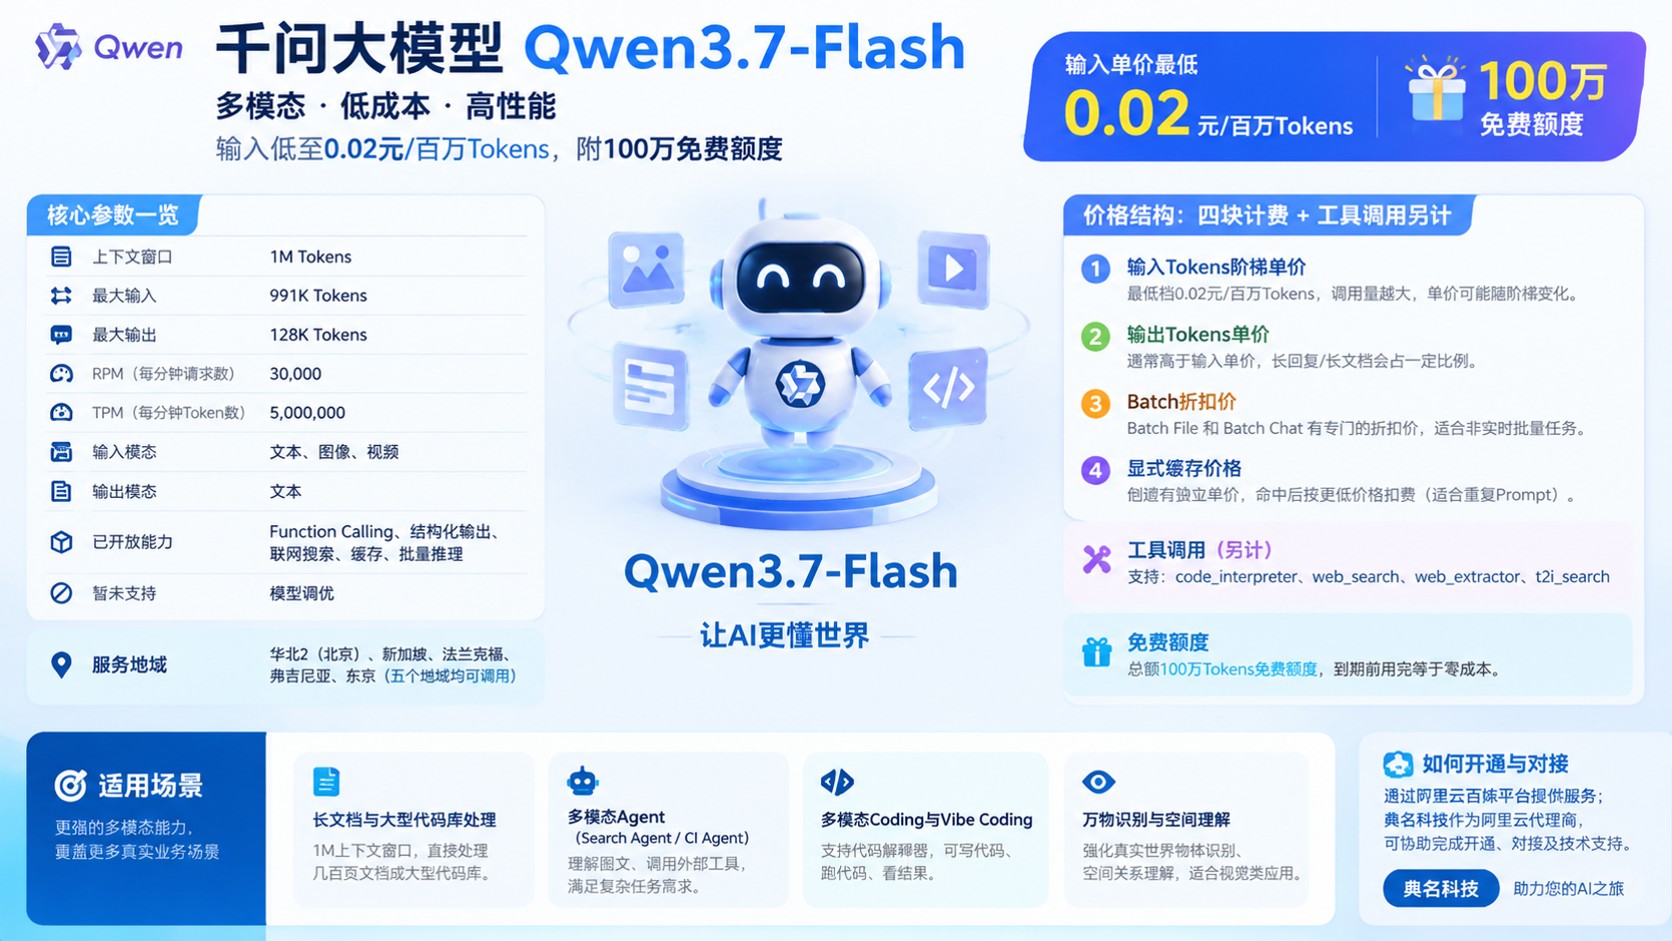
Qwen3.7-Flash的计费分四块:输入Tokens阶梯单价、输出Tokens单价、Batch折扣价、显式缓存价格,工具调用另计。输入最低档0.02元/百万Tokens,具体阶梯档位以百炼控制台最新报价为准。千问大模型Qwen3.7-Flash价格是多少取决于你的月调用量落在哪个档位,以及是否走Batch通道和缓存命中。
输入和输出分开计价,输出单价通常高于输入。Batch File和Batch Chat有独立折扣价,批量离线任务走Batch通道单次成本更低。显式缓存创建有独立单价,命中后按更低价格扣费,重复Prompt场景能省一笔。
工具调用方面,code_interpreter、web_search、web_extractor、t2i_search各有独立计价,一次复杂多模态请求如果叠加了web_search加长输出,实际花费会比纯文本高不少。做预算时建议把工具调用单独列出来算,别只按输入Token估。
Qwen3.7-Flash是什么:多模态能力与适用场景
Qwen3.7-Flash是通义千问原生视觉语言系列的Flash轻量模型,核心标签是文本生成、视觉理解、深度思考。相较3.6-Flash,这一代强化了多模态基础与万物识别能力,在真实世界感知和空间智能上有进一步提升。
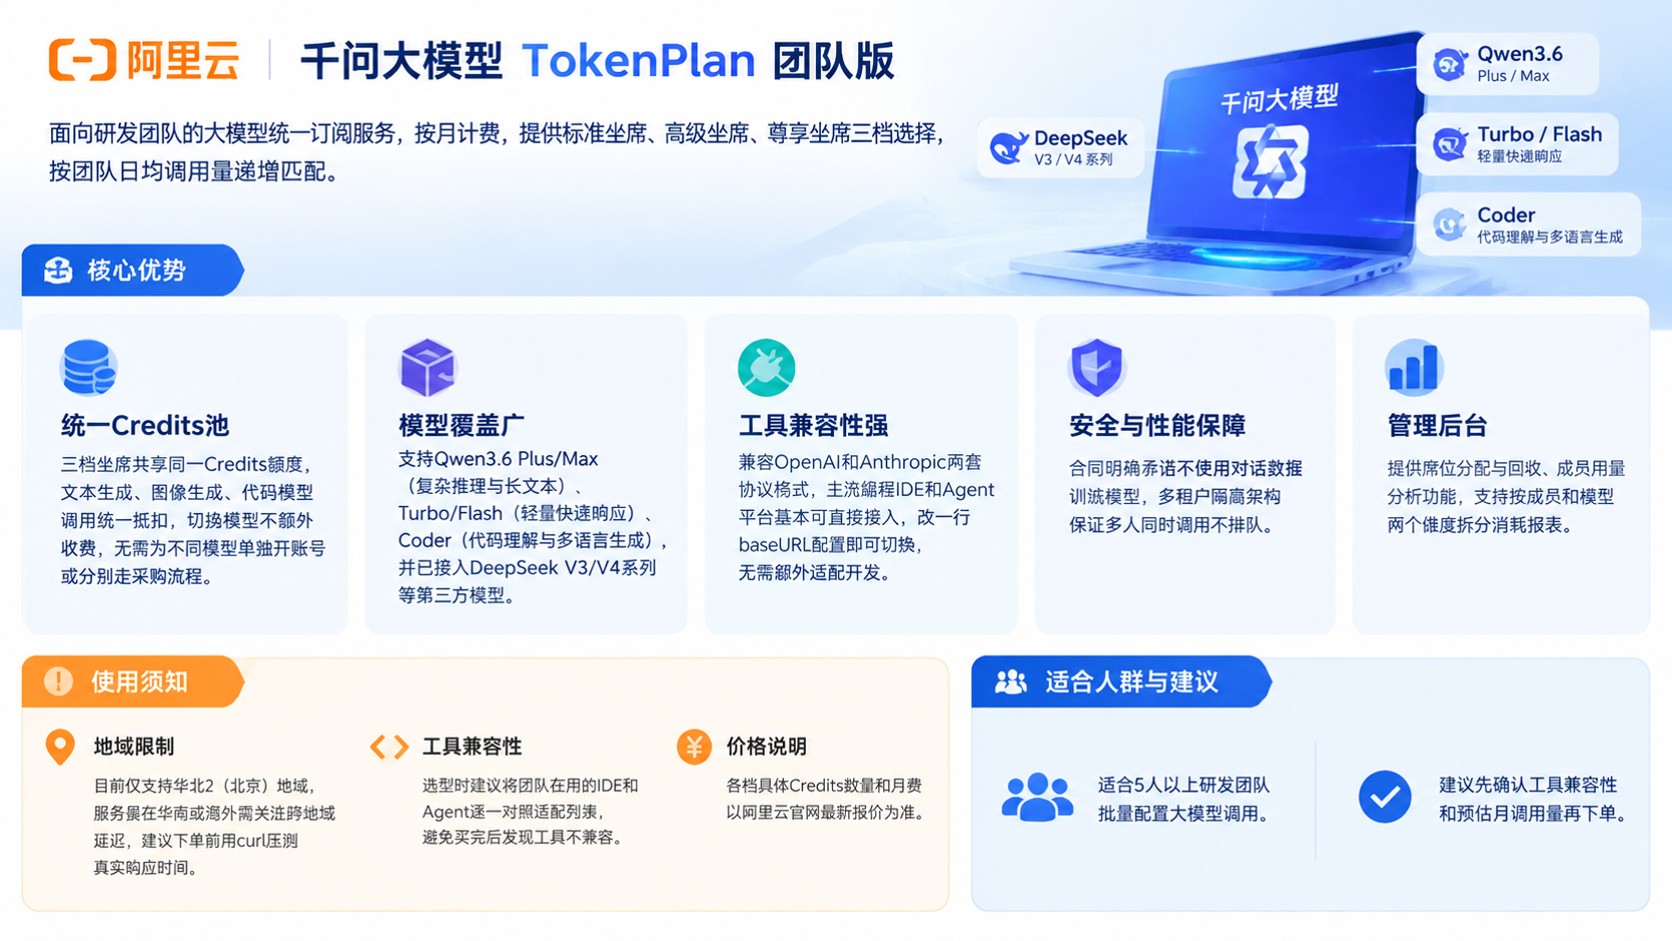
参数层面,上下文窗口1M、最大输入991K、最大输出128K、RPM 30000、TPM 5000000。支持文本、图像、视频输入,文本输出;function calling、结构化输出、联网搜索、缓存、批量推理均已开放,模型调优暂未支持。在华北2(北京)、新加坡、法兰克福、弗吉尼亚、东京五个地域提供服务。
适用场景比较明确:长文档和大型代码库处理、Search Agent和CI Agent等多模态Agent、多模态Coding和vibe coding、万物识别与空间理解。如果你在做一个需要同时理解图文并调用外部工具的Agent,这个模型规格够用且成本可控。
千问大模型Qwen3.7-Flash价格是多少:阶梯单价与免费额度
千问大模型Qwen3.7-Flash价格是多少,核心看阶梯档位和免费额度。输入按调用量分阶梯,最低档0.02元/百万Tokens,调用量越大单价可能变化;输出单价独立计算。Batch File和Batch Chat有专门折扣价,离线批量任务优先走这条通道。
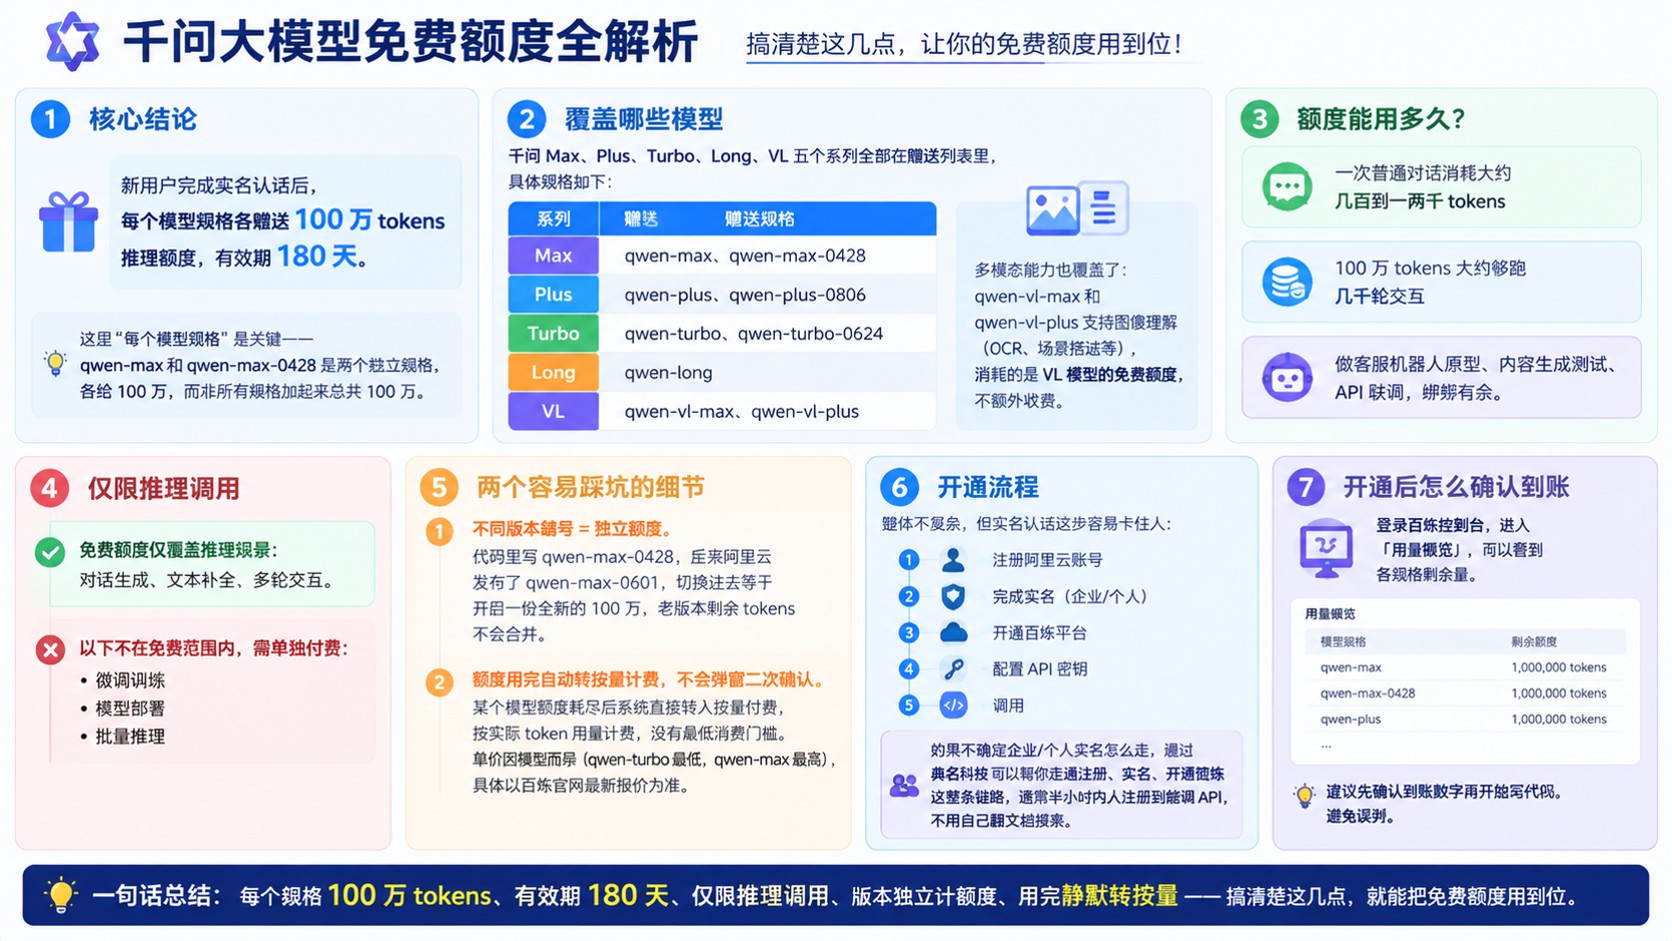
免费额度是总额100万Tokens,当前剩余100%,到期日10月23日。到期前用完等于零成本跑通整个流程,建议把开发和测试阶段的调用都放在免费额度内完成。超出后按阶梯价正常计费,不会断服务。
显式缓存分创建和命中两个价格,创建时按正常输入价计费,命中后按更低价扣费。如果你的业务有大量重复Prompt(比如固定系统提示词加变量),开缓存能把这部分成本压下来。具体各档位单价以百炼控制台实时显示为准。
选大模型API接入渠道看哪几个维度
选接入渠道主要看四个维度:资质授权、计费透明度、技术实施能力、售后响应。资质看是不是阿里云官方授权渠道,能不能开正规发票;计费看阶梯档位是否清晰、Batch折扣能否叠加、缓存命中价是否单独列出。
技术实施能力决定接入的顺畅程度——能不能协助OpenAI兼容模式接入、多模态调试、限流参数配置。售后看限流调整、模型版本升级通知、账单异常有没有专人跟进,还是只能提工单等回复。
千问大模型Qwen3.7-Flash价格是多少这件事,通过正规渠道能拿到准确的阶梯报价和Batch折扣信息。自己上官网也能看到标准价,但如果你需要有人帮你把开通、调试、限流配置一次性搞定,找有技术对接人的渠道会省不少时间。通过典名科技这类阿里云代理商确认报价时,把月调用量说清楚就能拿到对应档位的参考价。
官网直购与通过阿里云代理商购买有什么区别
官网直购是注册百炼平台后自助开通,按标准阶梯价计费,操作简单但全靠自己。适合已有技术团队、熟悉API接入的开发者,从注册到调通通常1-2天能完成。
通过阿里云代理商购买,区别在于有人帮你确认最新阶梯档位和Batch折扣、提供对公结算与正规发票、接入调试有技术对接人。流程上多一步沟通,但省掉了自己翻文档踩坑的时间。通过典名科技对接时,从需求确认到调通都有人跟,不用自己盯。
对比要点:费用上标准价vs可协商档位;流程上自助vs有人带;售后上工单vs专人跟进;付款上信用卡/支付宝vs对公转账。如果你是企业采购、需要对公发票,或者团队里没有专门盯AI工程的人,走代理商渠道更合适。
Qwen3.7-Flash怎么买更省钱:折扣与续费
千问大模型Qwen3.7-Flash价格是多少,省钱的关键在于用对通道。Batch File和Batch Chat有独立折扣价,批量离线任务(比如批量标注、离线分析)优先走Batch通道,单次成本比实时调用低。
显式缓存命中价格低于正常输入价,重复Prompt场景(固定系统提示词)开缓存能省一块。免费额度100万Tokens在到期日前用完等于零成本,建议先用免费额度跑通开发测试,再接正式生产调用。
阿里云大模型API按月结算,没有传统续费概念。但如果你调用量长期稳定在某个档位,可以通过渠道确认是否有阶梯优惠或年度框架协议。通过典名科技对接时,把调用量预估和预算周期说清楚,让对方帮你匹配最合适的方案。
用Qwen3.7-Flash API容易踩的3个坑
第一个坑:免费额度有到期日(10月23日),过期后直接按阶梯价扣费,不会提前通知你。提前在百炼控制台设用量告警,快到100万Tokens时收到提醒,避免超支不察觉。
第二个坑:生产环境并发没控好。RPM上限30000、TPM上限5000000,超过就返回429限流。上线前做压测确认峰值不会触发限流,特别是多模态请求单次Token消耗大,TPM容易先打到上限。
第三个坑:千问大模型Qwen3.7-Flash价格是多少,很多人只看了输入单价就估算成本,没算工具调用和输出单价。一次复杂请求含web_search加128K长输出,实际花费可能是纯文本场景的数倍。做预算时把输入、输出、工具调用三项分开算。
从开通到调通的落地步骤
第一步是需求确认:明确月调用量级、需要哪些模态(纯文本/图文/Agent)、是否用到工具调用。产出物是一份预估月账单区间,后续报价和方案都基于这个数字。
第二步账号与授权:开通百炼平台、获取API Key、确认限流参数(RPM 30000、TPM 5000000)。如果走典名科技这类代理商渠道,这一步由对接人协助完成,预计半天到1天。第三步接入调试:用OpenAI兼容模式Python SDK跑通基础调用,含深度思考流式输出,预计1-2天。
第四步压测与限流配置:模拟峰值RPM和TPM,确认不会触发429,产出压测报告。第五步上线与监控:配置用量告警和账单阈值提醒,进入正式生产,按月复盘调用量与费用变化。整个流程顺利的话5-7天能从零走到生产环境。
典名科技:阿里云大模型接入与计费方案
典名科技是阿里云代理商,专注于提供高质量的阿里云服务器和阿里云数据库解决方案,同时覆盖大模型API接入服务,帮客户把百炼平台从开通到调通一次做完。如果你不确定千问大模型Qwen3.7-Flash价格是多少、不确定走哪个通道划算,可以直接找他们确认最新阶梯报价和Batch折扣。
合作方式:联系典名科技,说明你的业务场景、预估月调用量、是否需要工具调用和对公发票,对方会给出对应档位的报价和接入方案。支持对公结算与正规发票,适合企业采购流程。合作后日常使用中遇到限流调整或账单疑问,有对接人跟进处理。
适合谁:需要接入Qwen3.7-Flash但缺专职AI工程团队的企业、想省时间走代理商渠道的开发者、需要有人盯限流和账单的中小团队。如果你只是个人开发者、调用量很小、对价格不敏感,官网直购也够用,不一定要走渠道。
常见问题
千问大模型Qwen3.7-Flash价格是多少?
输入最低0.02元/百万Tokens,按阶梯计费,输出和工具调用另计。当前有100万Tokens免费额度,到期前用完零成本。具体各档位单价以百炼控制台实时显示为准,Batch通道有独立折扣价。
Qwen3.7-Flash免费额度多久到期,超了怎么办?
总额100万Tokens,到期日10月23日,超后按阶梯价正常计费,不会断服务。建议把开发和测试阶段的调用都放在免费额度内完成,到期前在控制台设用量告警提醒自己。
通过阿里云代理商买大模型API能便宜多少?
标准价是官网公开的阶梯价,通过渠道可以确认是否有额外折扣或Batch优惠叠加。通过典名科技对接时把月调用量说清楚,对方会给出对应档位的报价,具体折扣以实际沟通为准。
Qwen3.7-Flash支持哪些输入模态和工具?
支持文本、图像、视频输入,文本输出。function calling、结构化输出、联网搜索、缓存、批量推理均已开放,模型调优暂未支持。适合多模态Agent、长文档处理、vibe coding等场景。
大模型API怎么开发票,能对公转账吗?
官网直购支持支付宝和信用卡,发票走阿里云自助流程。通过阿里云代理商采购走对公转账,发票由渠道方开具,适合有对公付款要求的企业。具体付款和开票方式以合作时确认为准。
Qwen3.7-Flash限流参数是多少,超了会怎样?
RPM上限30000,TPM上限5000000,超过直接返回429错误,不会排队等待。上线前做压测确认峰值不超限,多模态请求单次Token消耗大,TPM容易先打到上限。
没有AI工程团队能自己接入Qwen3.7-Flash吗?
技术上可以,OpenAI兼容模式SDK文档完善,个人开发者1-2天能跑通基础调用。但如果涉及多模态调试、限流配置、长期运维,找有技术对接人的渠道能省不少时间。通过典名科技可以有人帮你从开通到调通一次做完。