企业如何选购大模型机器人算力资源与功能卡
网站编辑2026-04-15 15:22:13125
很多企业在探索 AI 落地时,经常会产生关于阿里云如何购买大模型机器人功能卡的东西这类疑问。实际上,这种需求在技术层面是指如何获取支撑大模型运行的 GPU 算力资源或预集成的人工智能平台服务。企业最常见的痛点是面对复杂的计费模式(如按量付费与包年包月)以及硬件规格(如 A100、H100 或国产芯片)感到困惑,担心买错了导致推理延迟高或成本失控。
算力资源的获取方式与厂商差异
针对大模型机器人的底层算力需求,主流云厂商通常提供两种路径。一种是直接购买 GPU 云服务器(如阿里云的 ECS GPU 实例、华为云的 G 系列实例、AWS 的 P 系列实例),这种方式相当于租用一台带显卡的电脑,用户拥有最高控制权,但需要自行部署环境。另一种是使用模型平台服务(如阿里云 ModelStudio、腾讯云 TI 平台、Azure OpenAI Service),这种方式无需关注具体的卡,而是通过 API 调用或功能模块购买。据各厂商官方文档,对于初创企业,直接调用 API 的成本远低于维护整台 GPU 服务器。
功能卡与资源包的选型逻辑
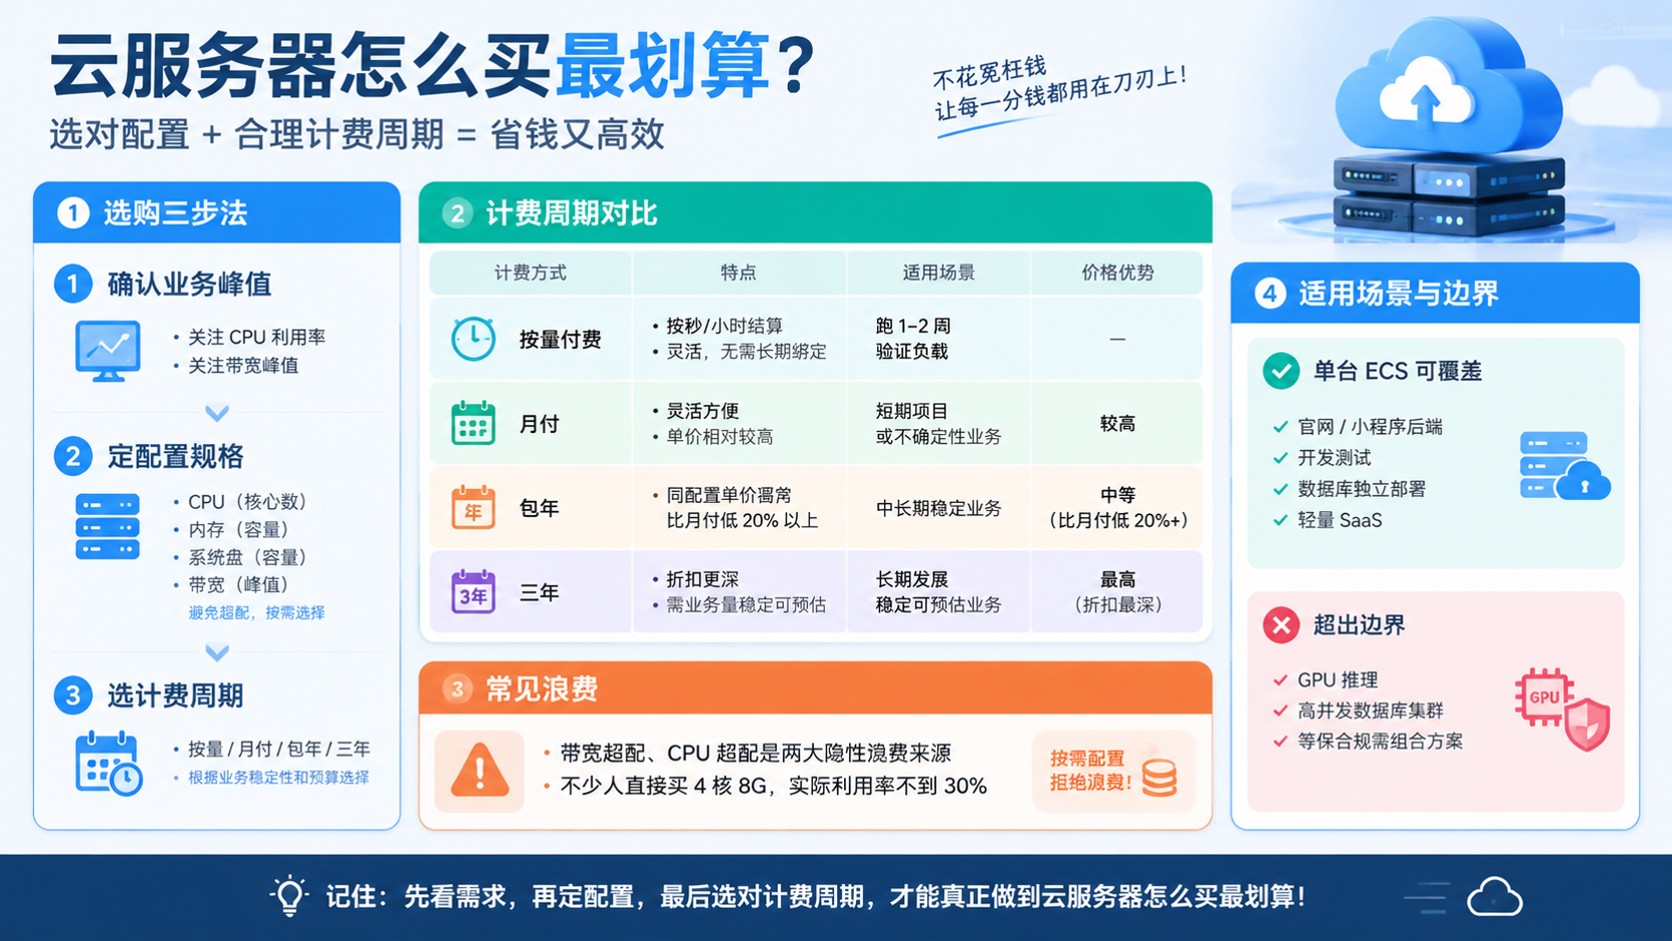
在实际操作中,所谓的“功能卡”往往对应的是资源包或配额(Quota)。企业在选择时,最大的痛点在于无法预估 Token 消耗量导致预算超支。以大模型推理为例,阿里云提供基于 Token 的计费方案,而华为云在某些场景下支持算力券形式的抵扣,AWS 则倾向于预留实例(Reserved Instances)来降低长期成本。如果你不确定业务量,建议先从按量计费开始,等流量稳定后再转换为资源包模式。这里有个细节,不同厂商对显存的切分粒度不同,部分平台支持虚拟 GPU(vGPU),允许将一张物理卡切分成多个小单元,这能显著提升资源利用率。
多云环境下的大模型部署建议
为了避免被单一供应商锁定,很多架构师在考虑阿里云如何购买大模型机器人功能卡的东西时,会同步调研多云部署方案。例如,核心训练任务可以放在算力储备充足的华为云昇腾集群,而面向用户的推理接口则分布在阿里云或腾讯云的边缘节点以降低延迟。某金融客户在实测中发现,采用混合云策略,将非敏感数据交给公有云大模型,私有化部署关键业务模型,可以在保证合规性的同时,将整体算力成本降低约百分之三十。
总结与决策建议
无论是寻找特定的功能卡还是配置算力集群,核心不在于哪个平台最强,而在于你的业务场景是偏向“快速验证”还是“大规模生产”。建议企业首先明确模型参数规模,然后对比三家以上厂商的单 Token 价格与算力可用区分布。最后,一定要在正式大规模采购前,利用各平台的免费试用额度进行性能压测,确认推理速度满足机器人实时响应的要求。