阿里云如何购买模型信息库的数据库及多云选型指南
网站编辑2026-04-08 21:03:5141
很多企业在探索大模型落地时,经常询问阿里云如何购买模型信息库的数据库,核心痛点在于不知道该选择传统的结构化数据库还是专门的向量数据库来存储模型所需的知识片段。通常情况下,企业面临的是海量非结构化数据无法高效检索的问题,导致 AI 回答出现幻觉。针对这一需求,主流云平台均提供了基于向量索引的存储方案,旨在将文本、图像等转化为向量空间中的坐标,实现语义级的快速匹配。
对于关注阿里云模型信息库数据库购买路径的技术负责人来说,最关键的决策点在于数据的规模与查询频率。目前,阿里云通过其向量数据库产品提供高性能的相似度检索,而华为云则依托其 GaussDB 的向量扩展能力实现类似功能,AWS 则通过 OpenSearch 或 Aurora 提供的向量支持来满足需求。据各厂商官方技术文档,这类数据库的核心差异在于索引算法(如 HNSW 或 IVF)的实现效率以及对大规模并发请求的响应速度。
在实际操作中,很多用户纠结于如何获取适合模型训练的数据库实例。一个典型的场景是:某金融客户需要构建行业知识库,起初尝试使用传统关系型数据库,但发现随着数据量增加,语义搜索的延迟大幅上升。随后他们对比了阿里云的向量数据库、腾讯云的向量检索服务以及 Azure AI Search。实测数据显示,在处理千万级向量维度时,专用向量数据库的检索延迟通常比通用数据库插件低一个数量级。建议在购买前,先明确你的数据维度(Dimension)和预期的 QPS(每秒查询率)。
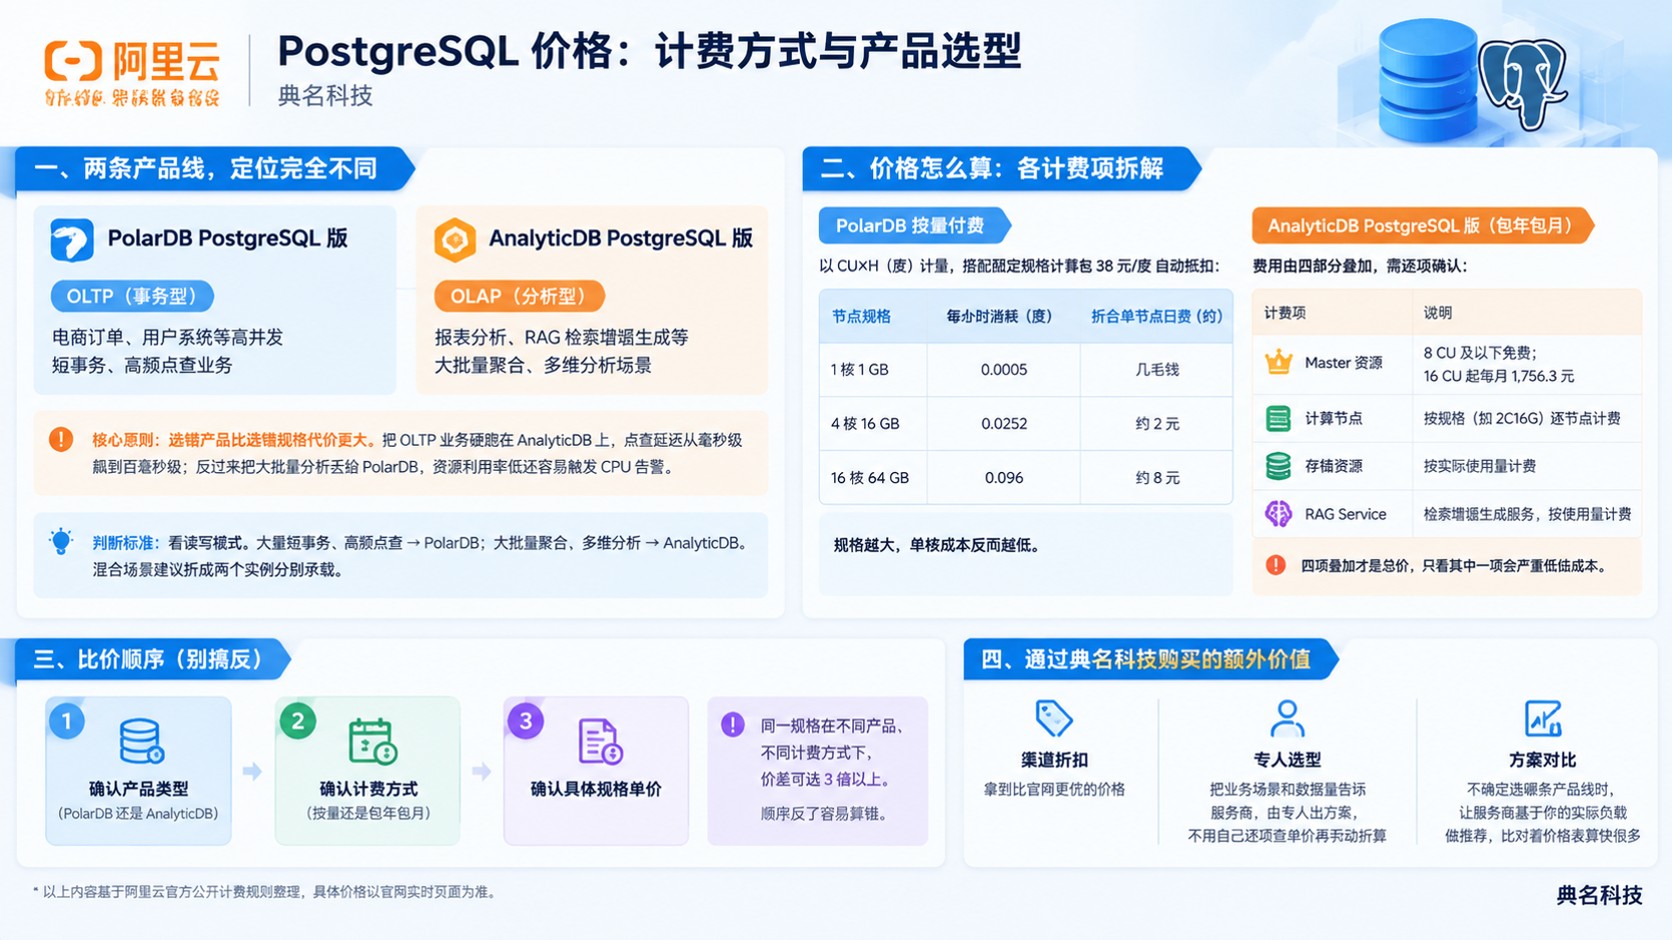
关于模型信息库数据库的成本优化,企业应避免盲目追求最高配置。大多数云厂商都支持按量付费或资源包模式。例如,在阿里云、华为云或 AWS 上,你可以先部署一个小规格的实例进行 POC(概念验证)测试,确认 Embedding 模型生成的向量长度与数据库配置匹配后再扩容。你可能会觉得“直接买顶配最稳”,嗯...但实际上,向量数据库的内存占用较高,如果索引策略设置不当,即使是高配实例也可能出现 OOM(内存溢出)现象。
综合来看,无论是研究阿里云如何购买模型信息库的数据库,还是在多云环境下进行选型,核心逻辑应遵循:业务场景定义 -> 向量维度确认 -> 厂商性能对标 -> 小规模实测。主流平台在功能上已趋同,但在国产化兼容性、计费灵活性以及生态集成度上各有侧重。建议架构师结合自身业务的实时性要求与预算,在至少两家供应商之间进行压力测试,以确保最终选定的方案能够支撑模型知识库的稳定运行。