阿里云服务器升级时间太长?怎么优化才不卡顿?
网站编辑2025-11-15 17:14:00126
企业用户常遇到这样的问题:“阿里云服务器升级时间太长”,导致业务中断、性能下降,甚至影响客户体验。尤其是在高峰期扩容或系统迁移时,漫长的等待不仅消耗资源,还可能引发连锁反应。那我们该如何应对?其实,这个问题背后涉及的不仅是阿里云的配置策略,更是多云环境下弹性升级的核心痛点。
为什么阿里云服务器升级要等这么久?
不少用户反馈:“阿里云服务器升级时间太长”,这背后的原因可能包括镜像同步、系统盘重建、安全组更新等多个环节。相比而言,AWS EC2 支持热迁移(Live Migration),在部分机型上可实现“不停机升级”;华为云也提供弹性裸金属实例快速替换方案。关键在于:你是否选择了支持快速部署的机型与区域?是否启用了预热镜像?这些都直接影响“升级时间”。
建议优先选择支持热迁移的机型(如阿里云g8a、华为云bm1、AWS m5n),并提前做好镜像缓存,可将升级等待时间缩短至分钟级。
升级时能否避免业务中断?
这是另一个高频搜索词:“阿里云服务器升级会停机吗?”答案是——取决于你的配置方式。阿里云默认升级流程需要重启或重建实例,但如果你使用了 Kubernetes 或 Serverless 架构(如阿里云SAE、腾讯云SCF),则可实现滚动更新或自动扩缩容,几乎无感知中断。
AWS EC2 Auto Scaling + Elastic Load Balancing 的组合已被验证为“无缝迁移”的经典方案;而天翼云的容器引擎同样支持类似能力。建议结合自身架构评估“冷启动”与“热部署”的成本差异。
多云环境下如何统一管理服务器升级?
“跨平台统一管理”是当前企业普遍面临的挑战。你可能同时使用了阿里云ECS、AWS EC2和华为云ECS,但每家的API接口、标签体系和告警机制各不相同。要解决这个问题,“工具链统一”是关键——使用 Ansible 或 Terraform 等开源工具自动化部署和升级流程,在多家平台上保持一致的操作逻辑。
某金融客户通过 Ansible 脚本对3家厂商的ECS进行批量系统补丁更新,将原本需数小时的手动操作压缩至30分钟内完成。
有没有更省事的办法?
如果你不想自己写脚本、也不愿频繁切换控制台,“自动化运维平台”可能是更高效的选择。目前主流厂商均已推出可观测性+自动化运维组合产品:阿里云ARMS + SAE、华为云DevOps + AOM、AWS CloudWatch + CloudFormation 等等,均能实现跨区域/跨平台的统一调度与告警响应。
注意:这类平台通常按事件计费,适合中大型项目;若预算有限,则建议先用免费工具验证可行性再逐步过渡。
怎么选机型才能少折腾?
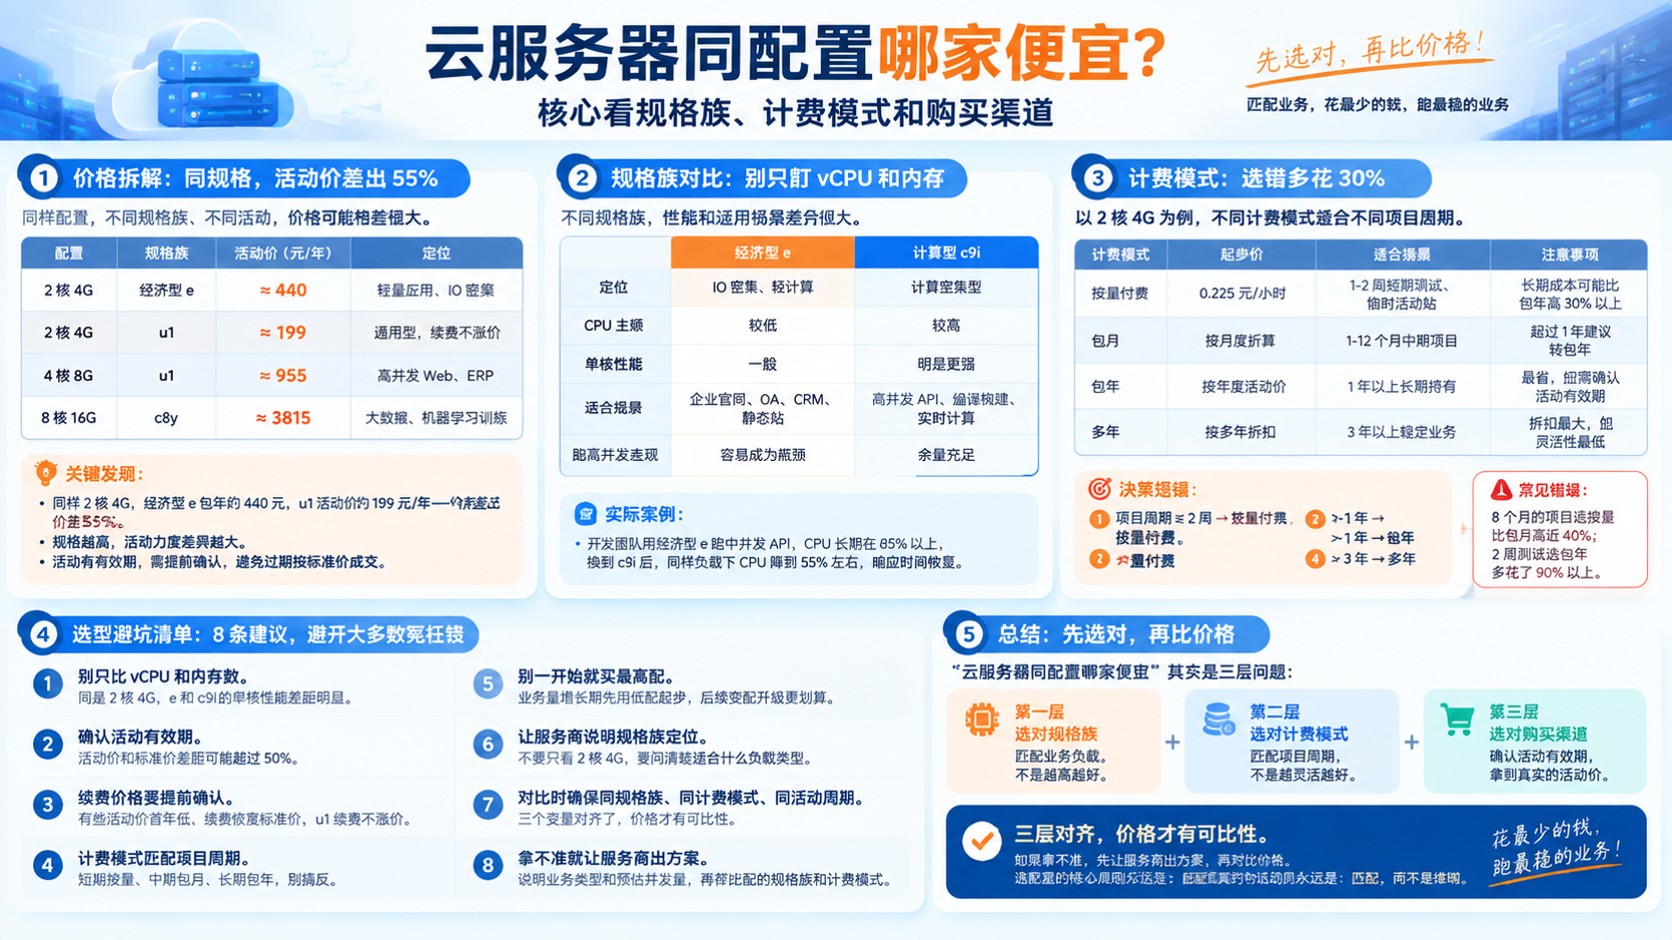
最后一个问题:“阿里云服务器选哪种机型最稳定?”其实这和“升级时间太长”的问题息息相关。突发型实例虽便宜,但CPU积分耗尽后性能骤降;而计算密集型实例虽然稳定,但成本高且灵活性差。
实践中我们常建议客户根据业务波动周期选择机型:如电商大促期可临时启用弹性裸金属或Spot实例(各家均有),平时则使用计算型+预留券组合降低成本并提升可靠性。
如果你也在被“阿里云服务器升级时间太长”困扰,不妨从这几个方向入手:一是评估是否选用支持热迁移的机型;二是优化镜像与脚本配置以减少依赖项;三是借助开源工具或平台实现多云统一管理。最终目标不是追求最快的速度,而是找到最贴合你业务节奏的方式——这才是真正的“不踩坑”。